护城河 / 图文与视频
[护城河]苹果如何用五年时间,把耳机变成了空间
图文全文
护城河
01
空间音频登场
2020 年 6 月,苹果全球开发者大会改在线上举行。没有舞台,没有掌声,数十万观看直播的开发者分散在世界各地的客厅里。但当一个 AirPods Pro 的功能演示出现在画面中时,许多人放下了手中的咖啡。登场介绍功能的是 AirPods 固件高级工程师 Mary-Ann,这时候的她对观众尚显陌生,不过她将会在两年之后贡献知名场面,惊艳全场。
她说苹果如今在小小的耳机中实现了,影院级别的沉浸式声音体验,耳机里发出的声音不再是传统的立体声,而是影院当中的多声道环绕声。那一刻,空间音频从技术专利走入了消费产品。这不是立体声的那种左边渐进、右边渐出的左右平移。这是声音在你转动头部时,依然锚定在某个外部空间的错觉。
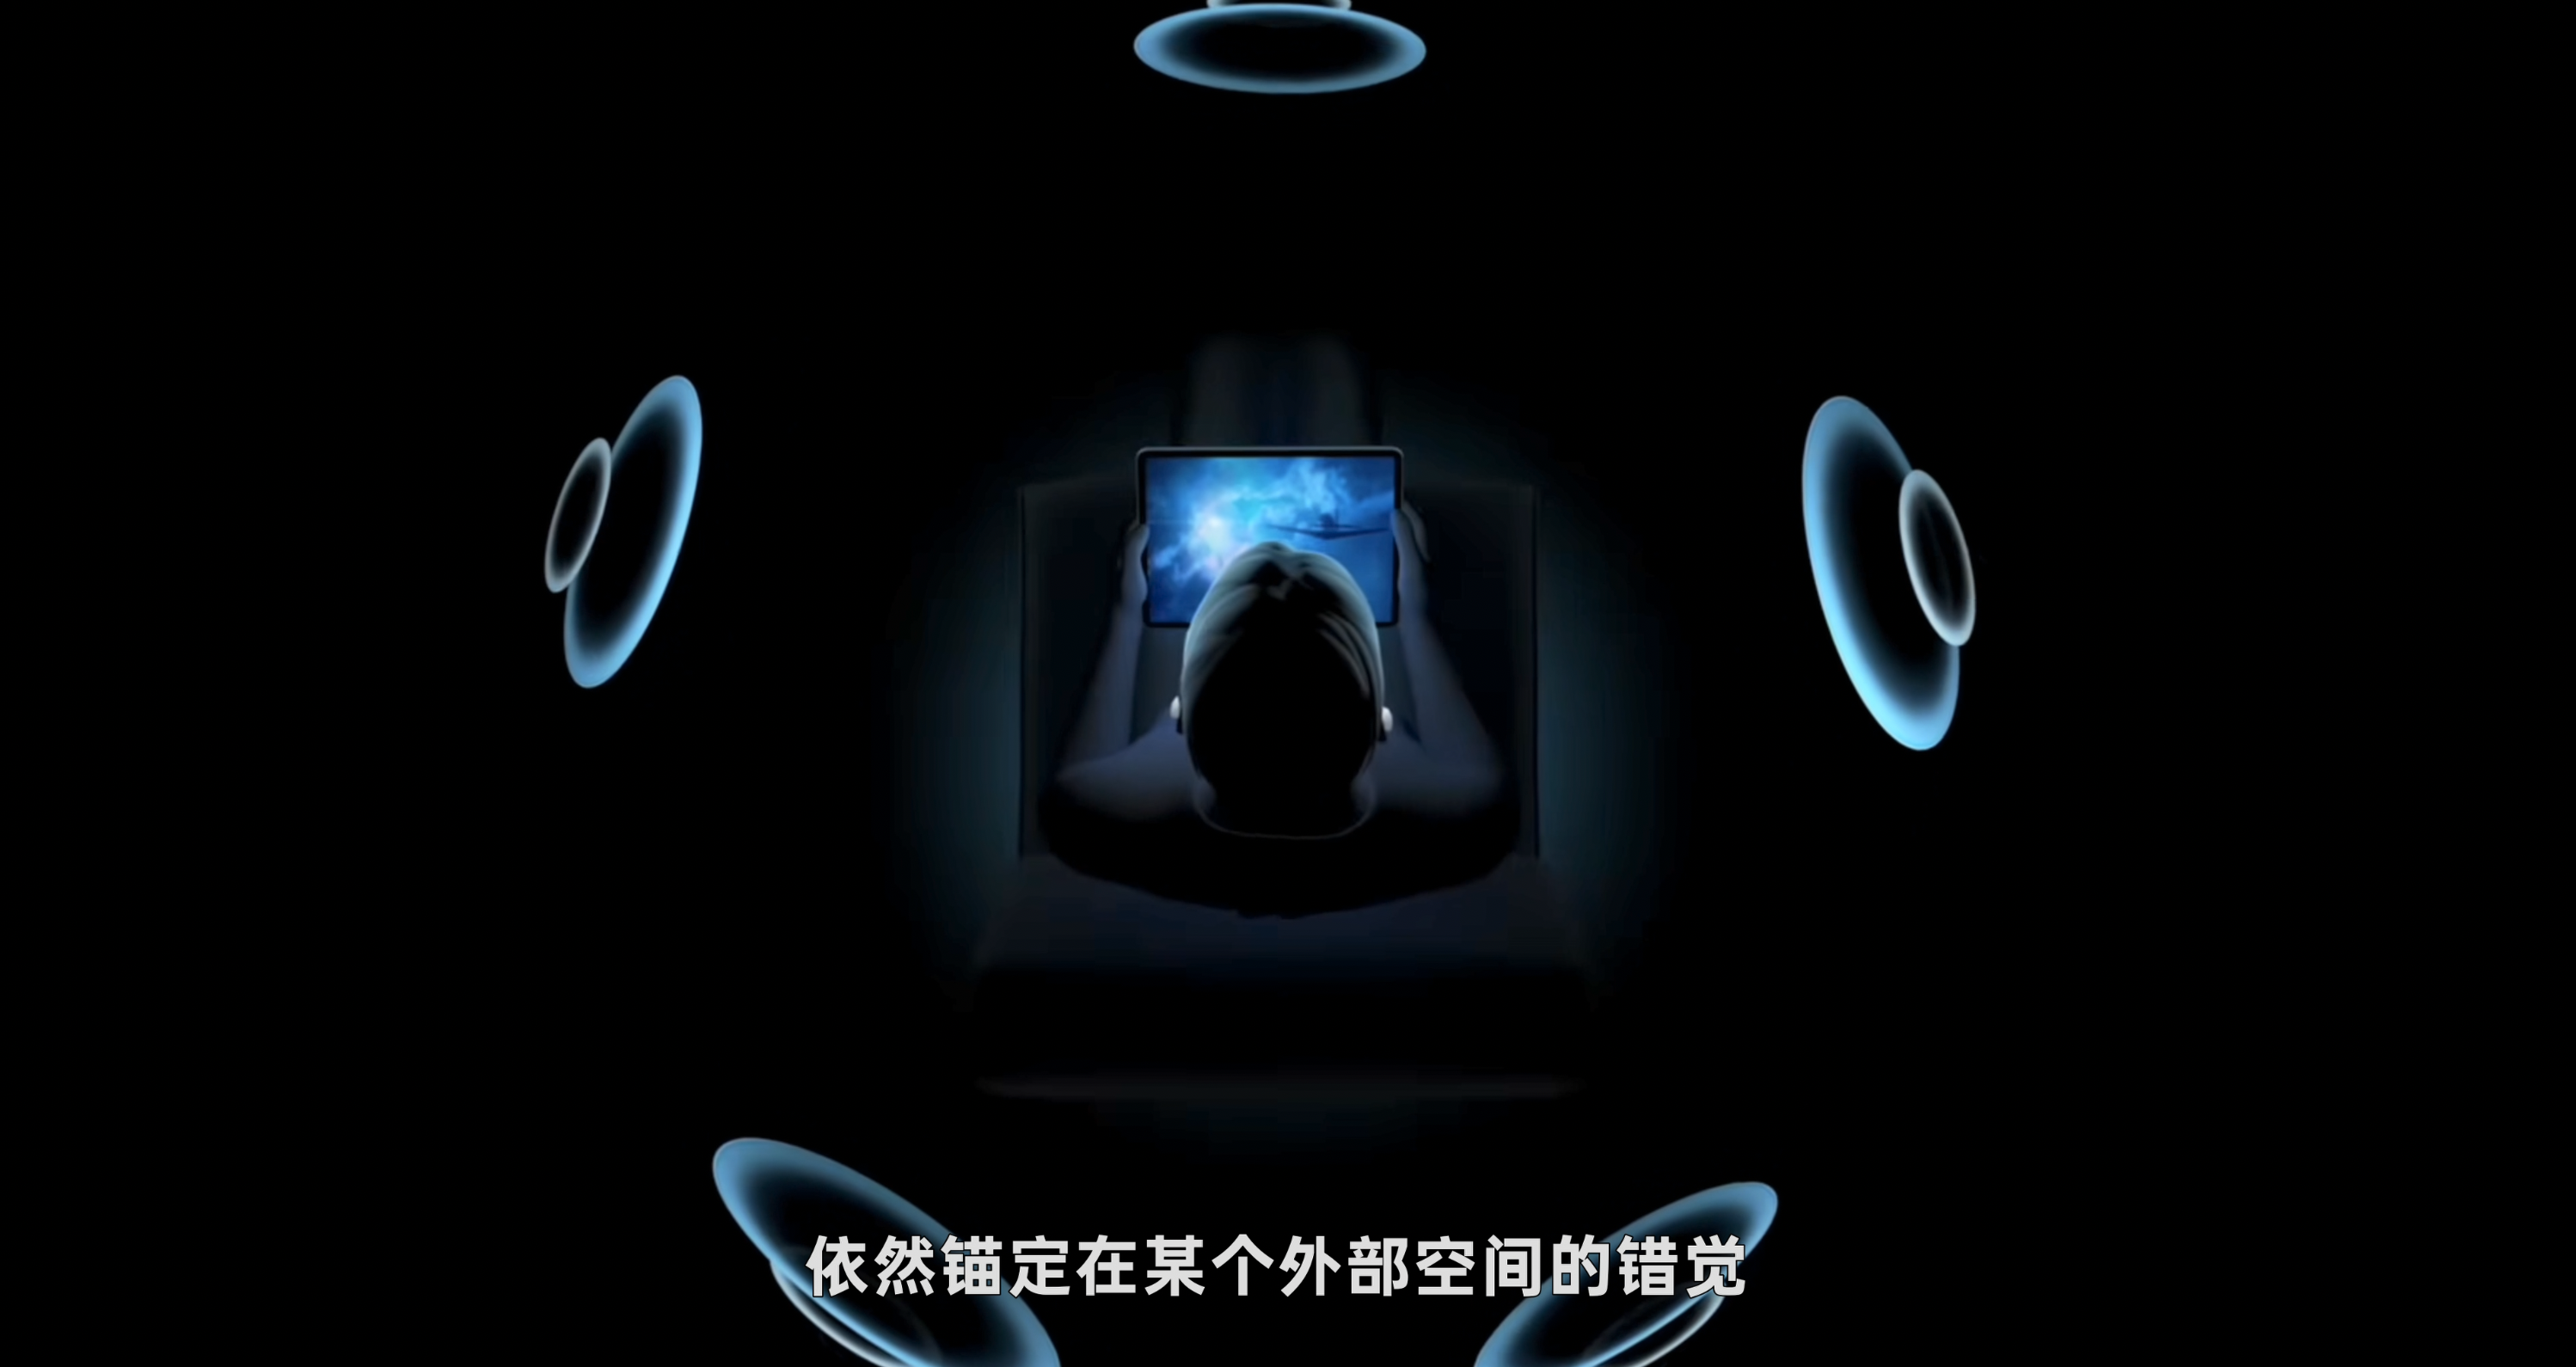
就像声音真的来自你面前的某个音箱,而不是两个塞进耳道的微型扬声器。耳机还是那个耳机。房间并不存在。但大脑信了。
苹果的发布文案写得克制:AirPods Pro 支持空间音频,带来影院般的聆听体验。但知道这项技术来龙去脉的人,看到的不是一句产品更新。他们看到的是一场持续多年的工程长征,和一张正在铺设的专利网。
02
耳机悖论
要理解空间音频为什么难,先得理解耳机为什么天然不适合它。
人类感知声音方位,依赖三个信号:声音到达两耳的时间差、强度差,以及外耳廓对声波的反射和滤波。三者合称头部相关传输函数,HRTF。
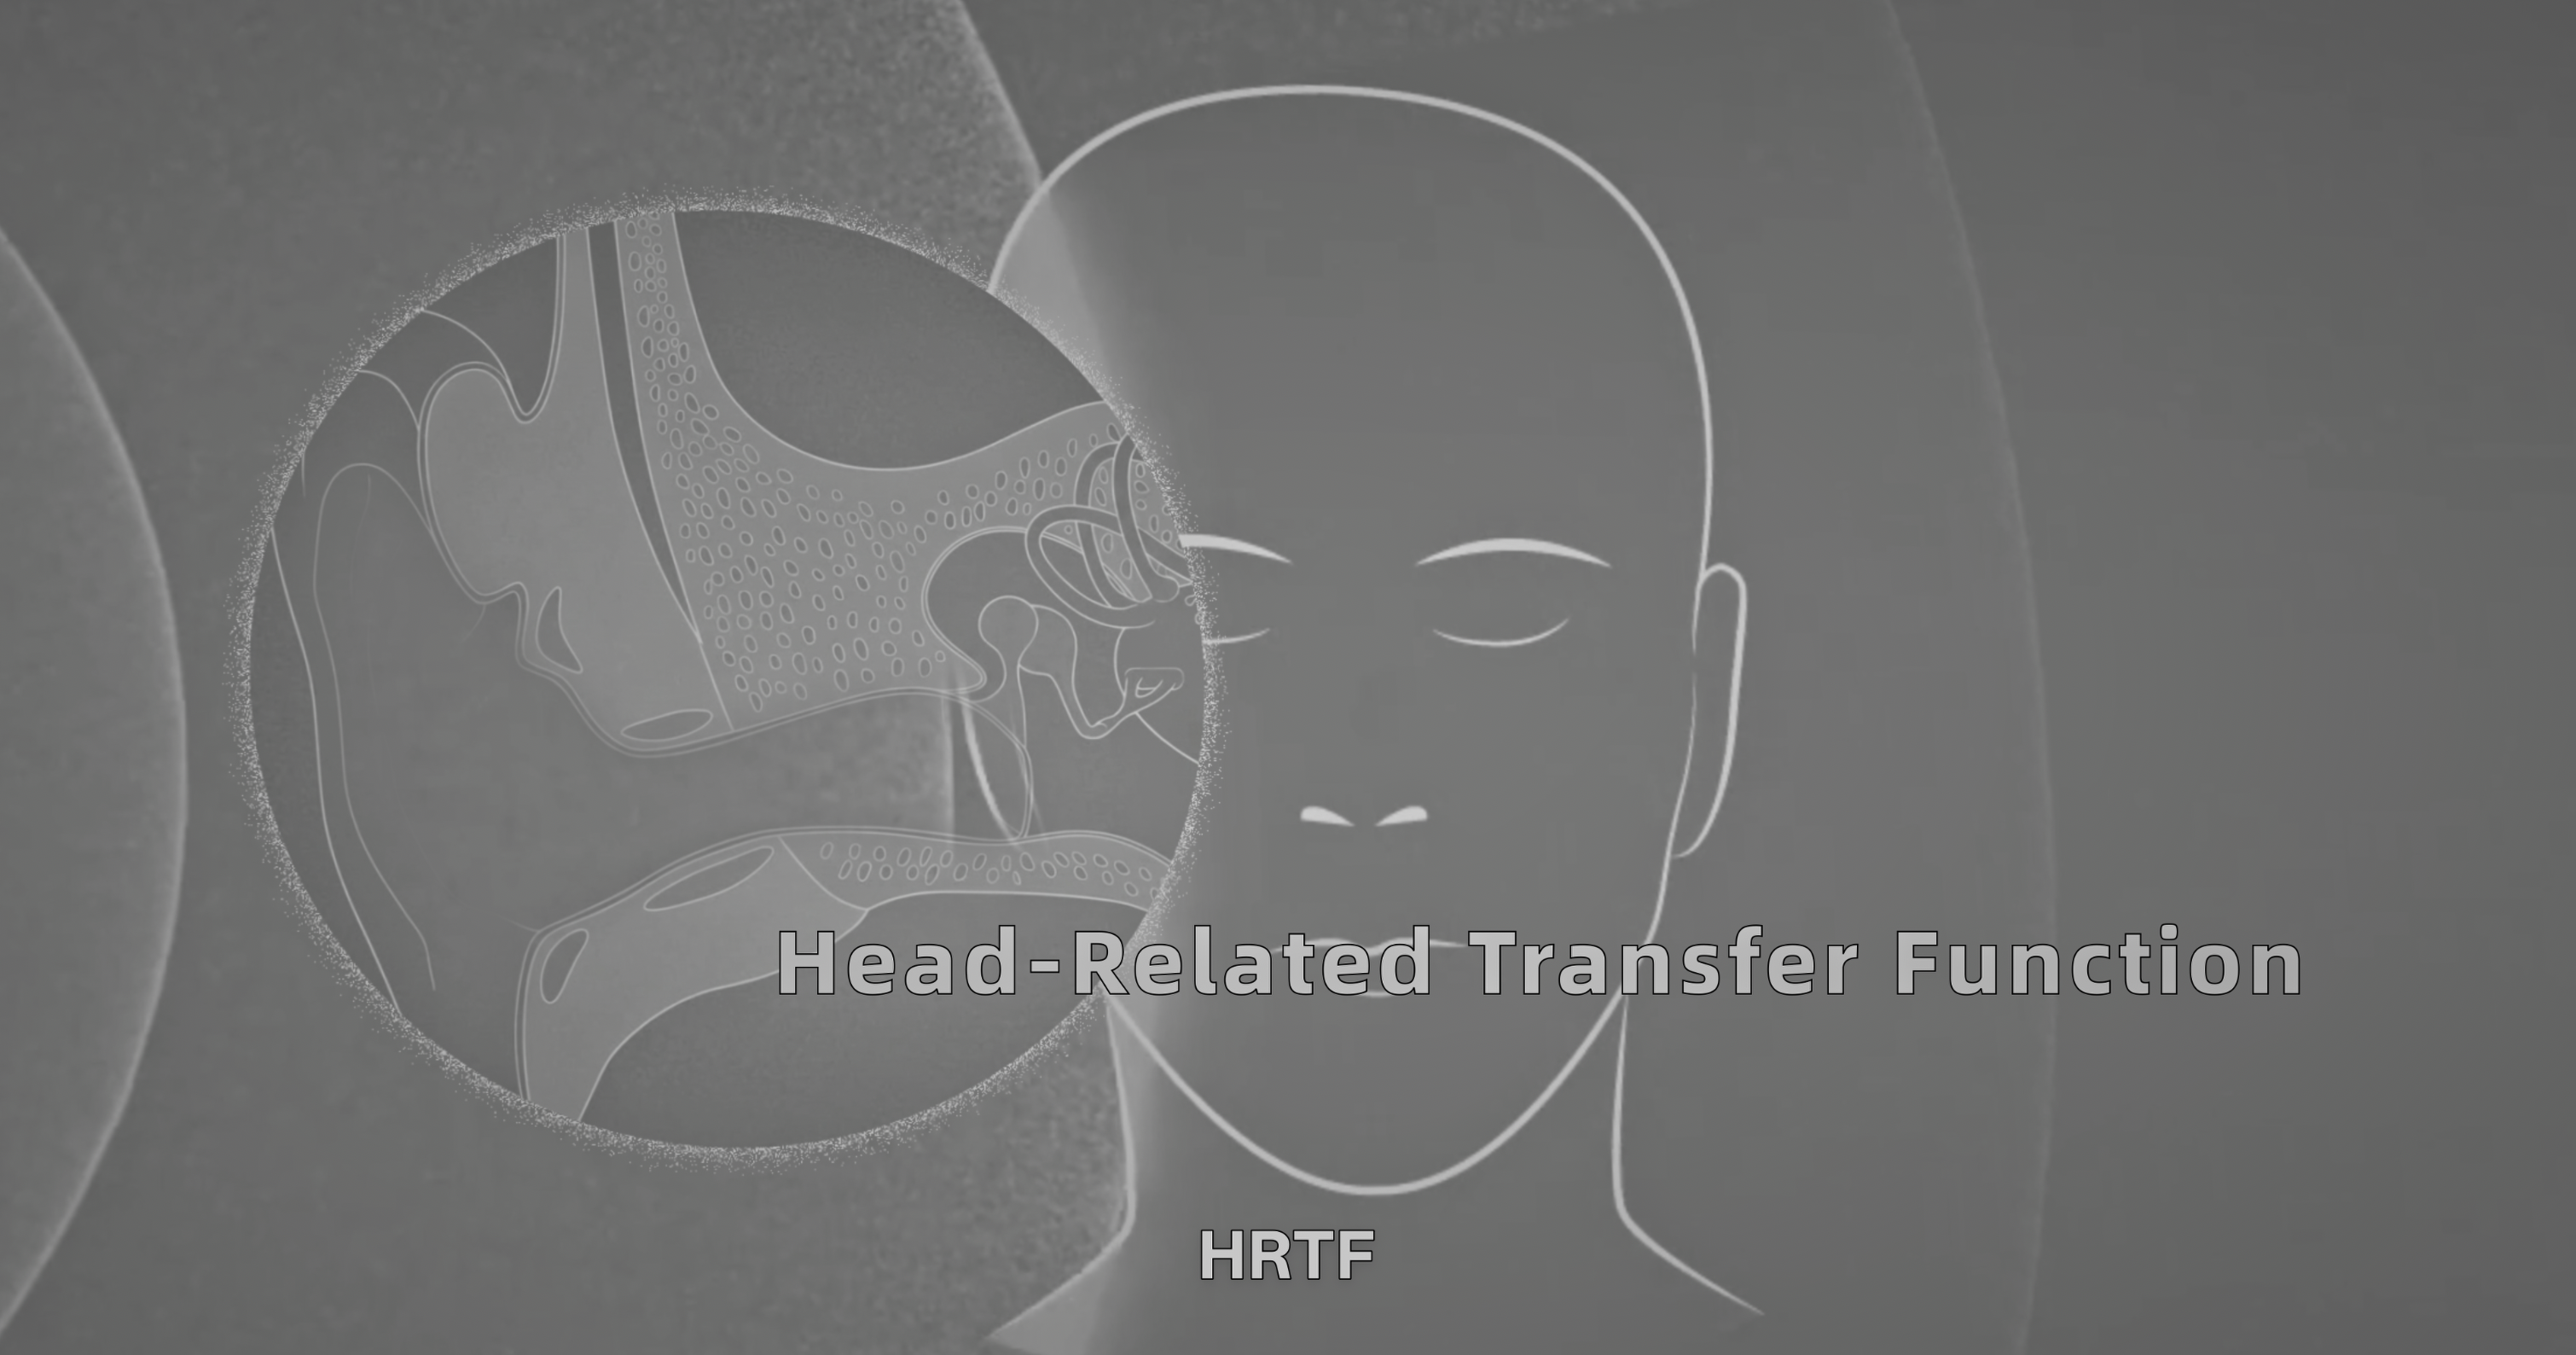
但耳机的问题在于,它直接把声音灌入耳道,绕过了外耳廓的自然滤波。大脑接收到的信号不是声音来自前方某处,而是声音在我的脑内播放,长期佩戴的疲劳感,声学工程师称之为头中效应。
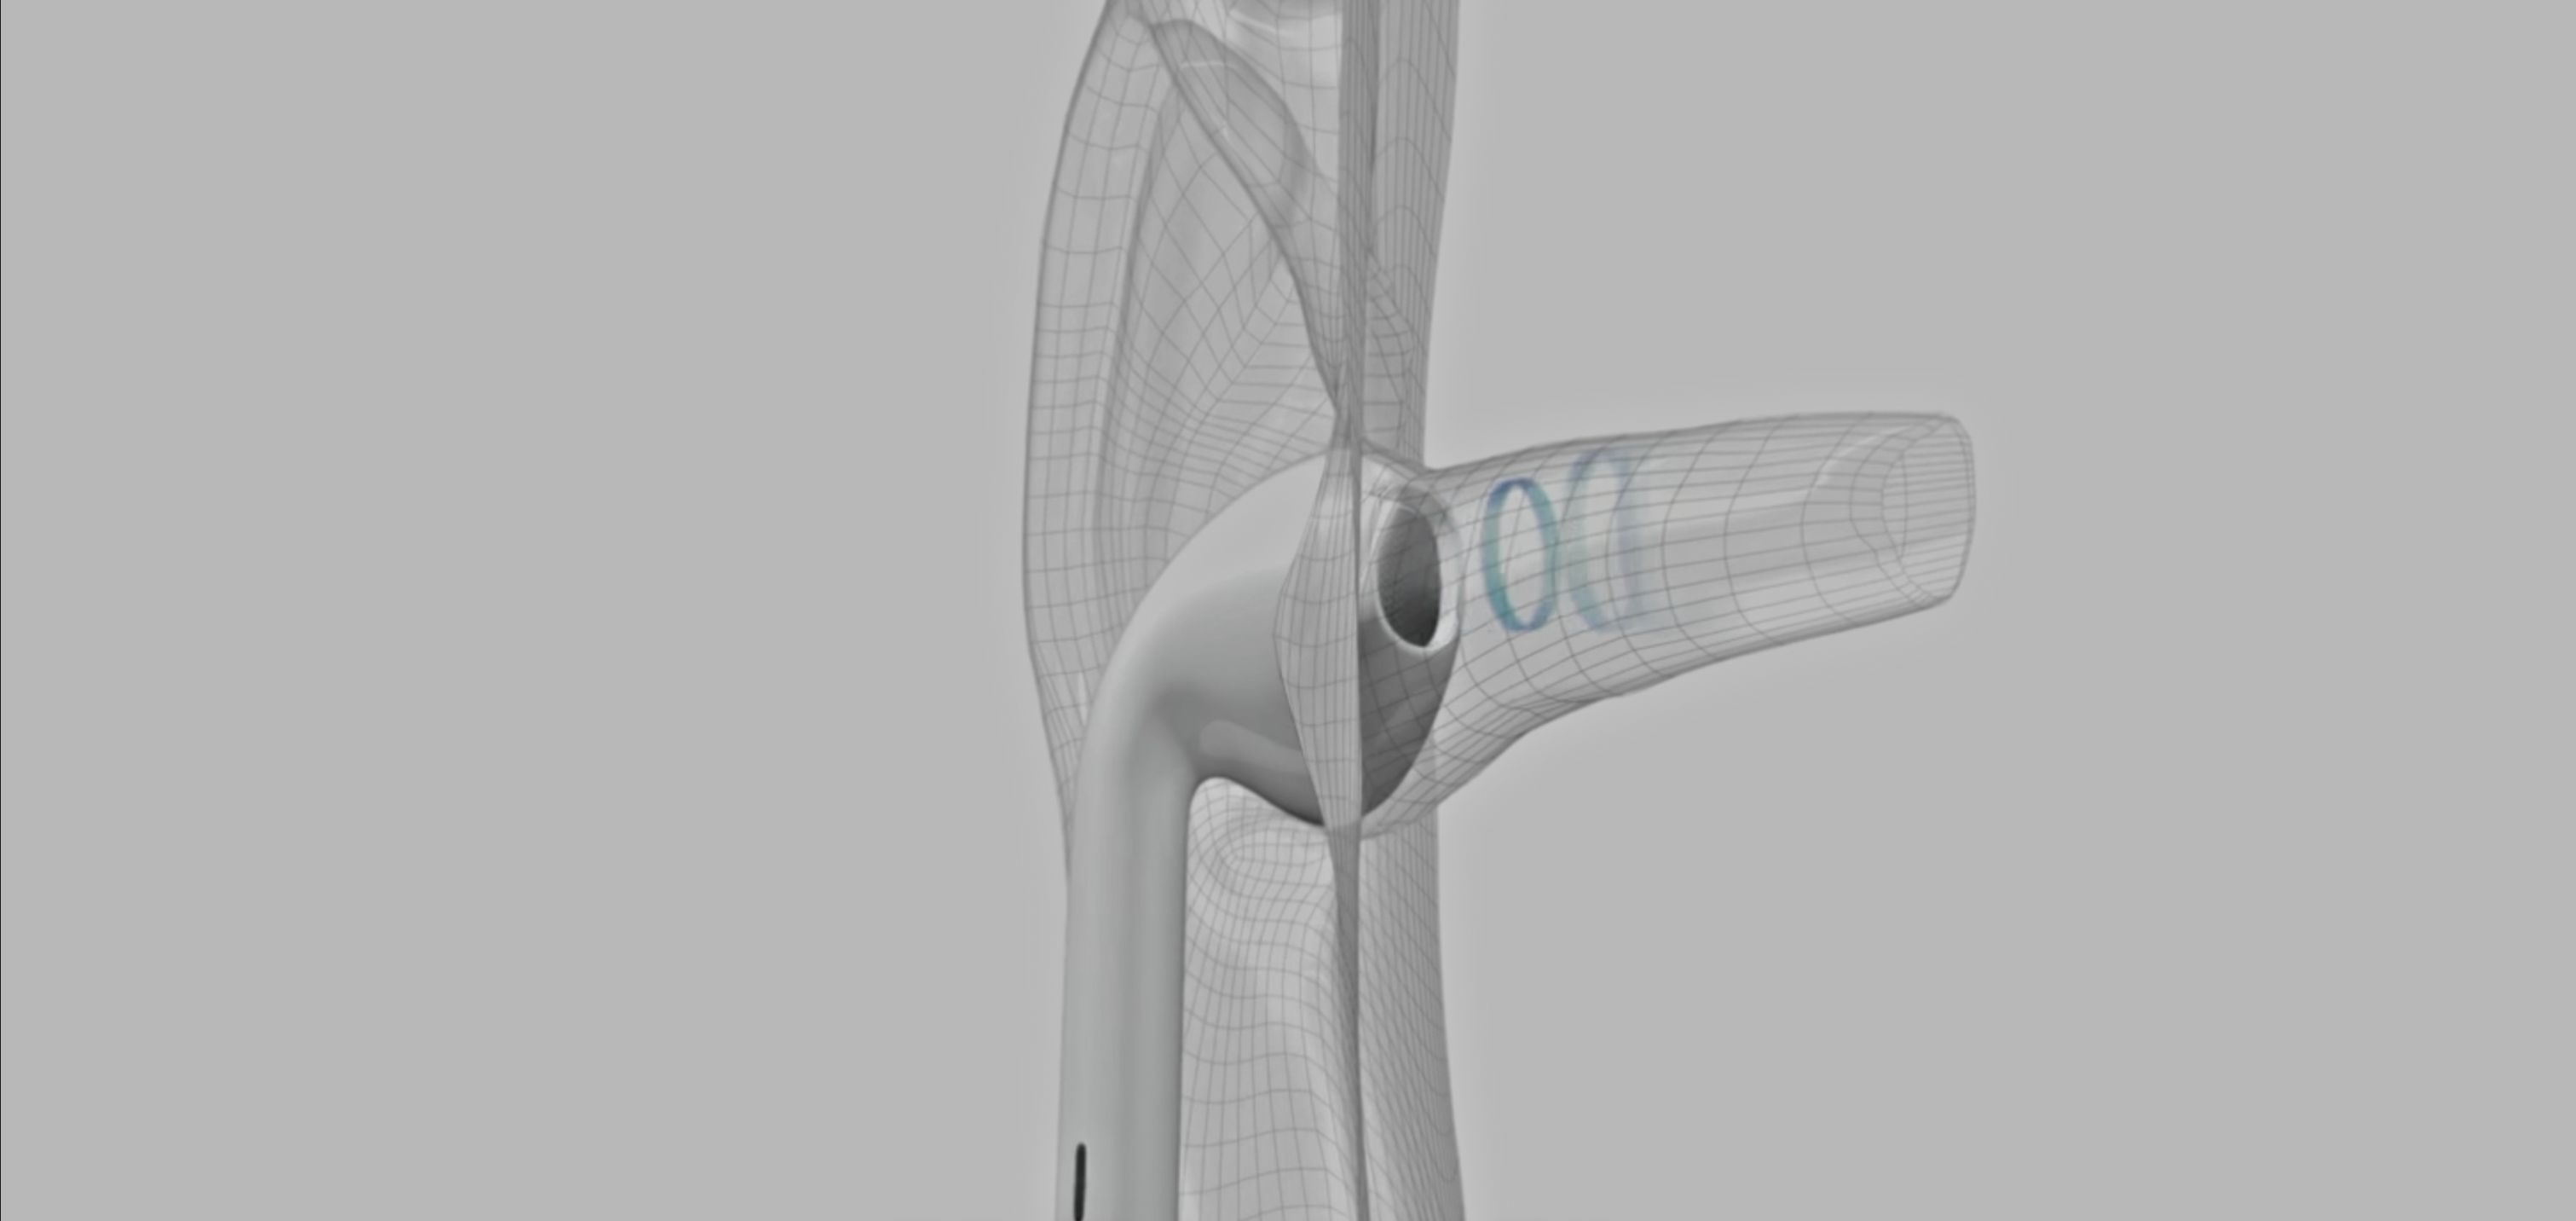
空间音频的核心任务,是在这种极受限的物理条件下,用算法欺骗大脑——让耳机里的声音,听起来像来自外部空间。这本身不是苹果独有的课题。索尼、杜比、谷歌都在做。
但真正让苹果的解法与众不同的是,从耳机里的陀螺仪,到手机的蓝牙传输协议,到操作系统里的音频渲染引擎,再到 Apple Music 里的编码格式——苹果控制了每一个环节。
苹果不是支持了空间音频这个功能——它是把整个音频链路重新设计了一遍,才让这个功能成为可能。
03
五年伏笔
但这一切并非 2020 年的突发奇想。
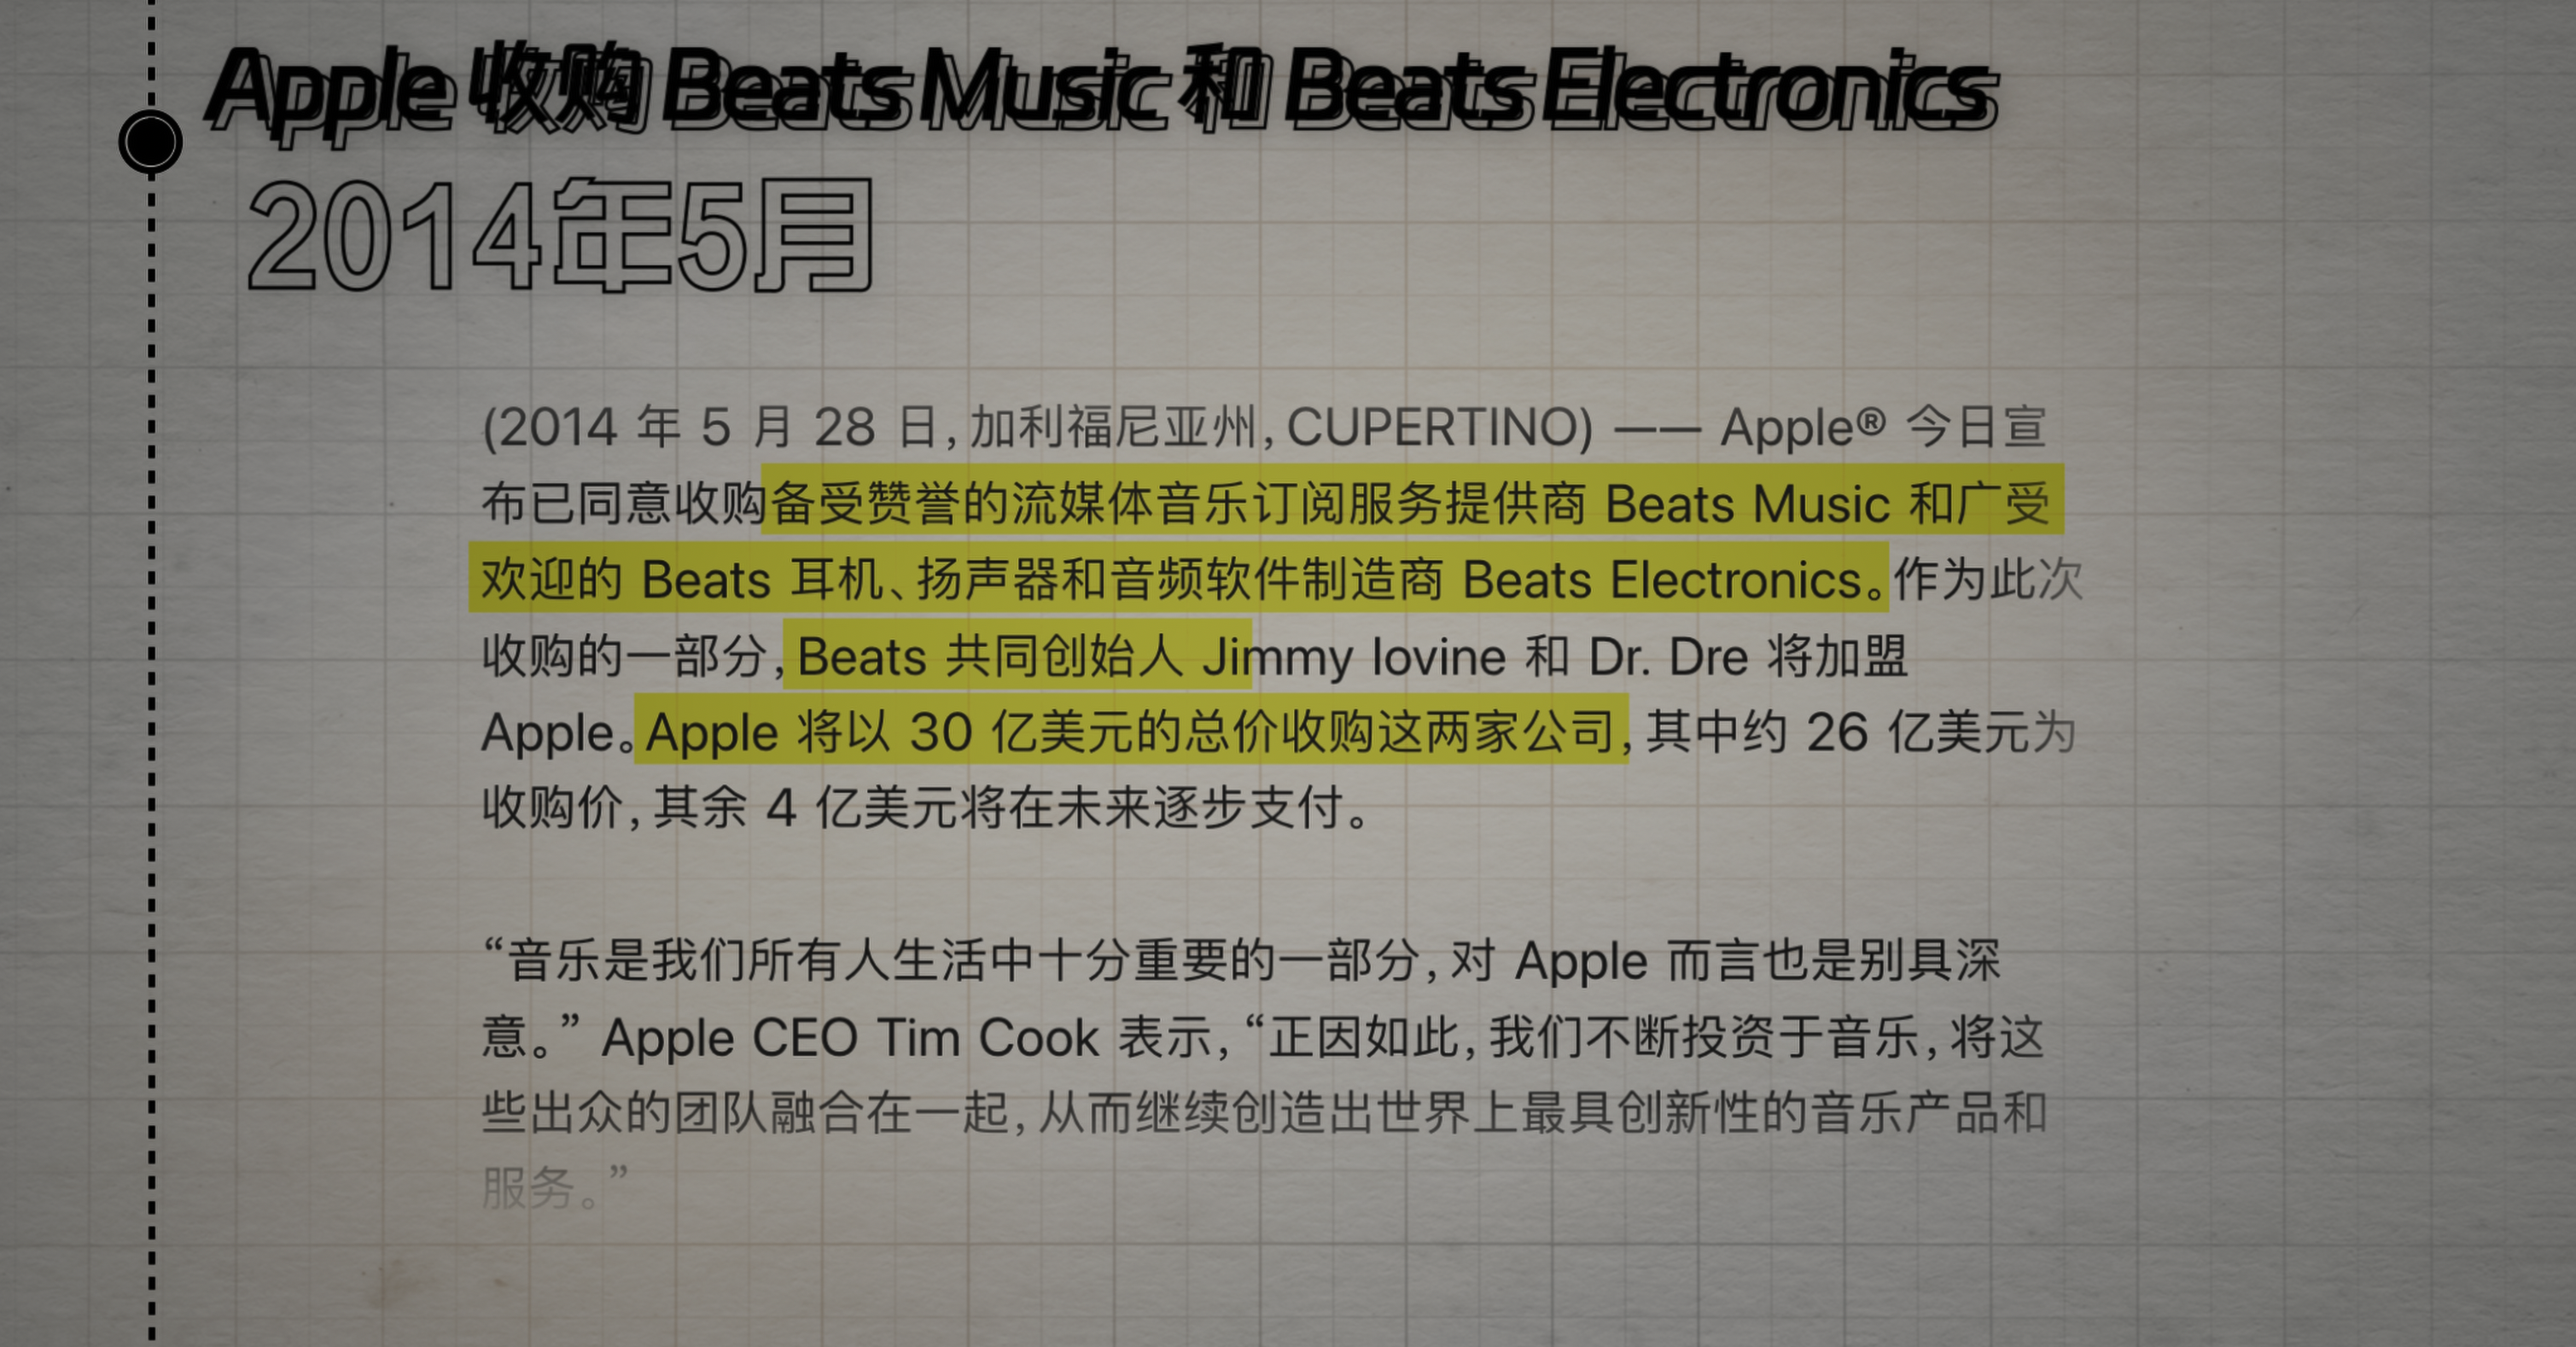
时间往回拨,2014 年 5 月,苹果以 30 亿美元收购 Beats Electronics。Beats 给苹果补上了耳机品牌、音乐服务和消费音频团队,原 Beats 的音频工程师转入苹果后,成了后续 AirPods 和空间音频研发的底层班底。
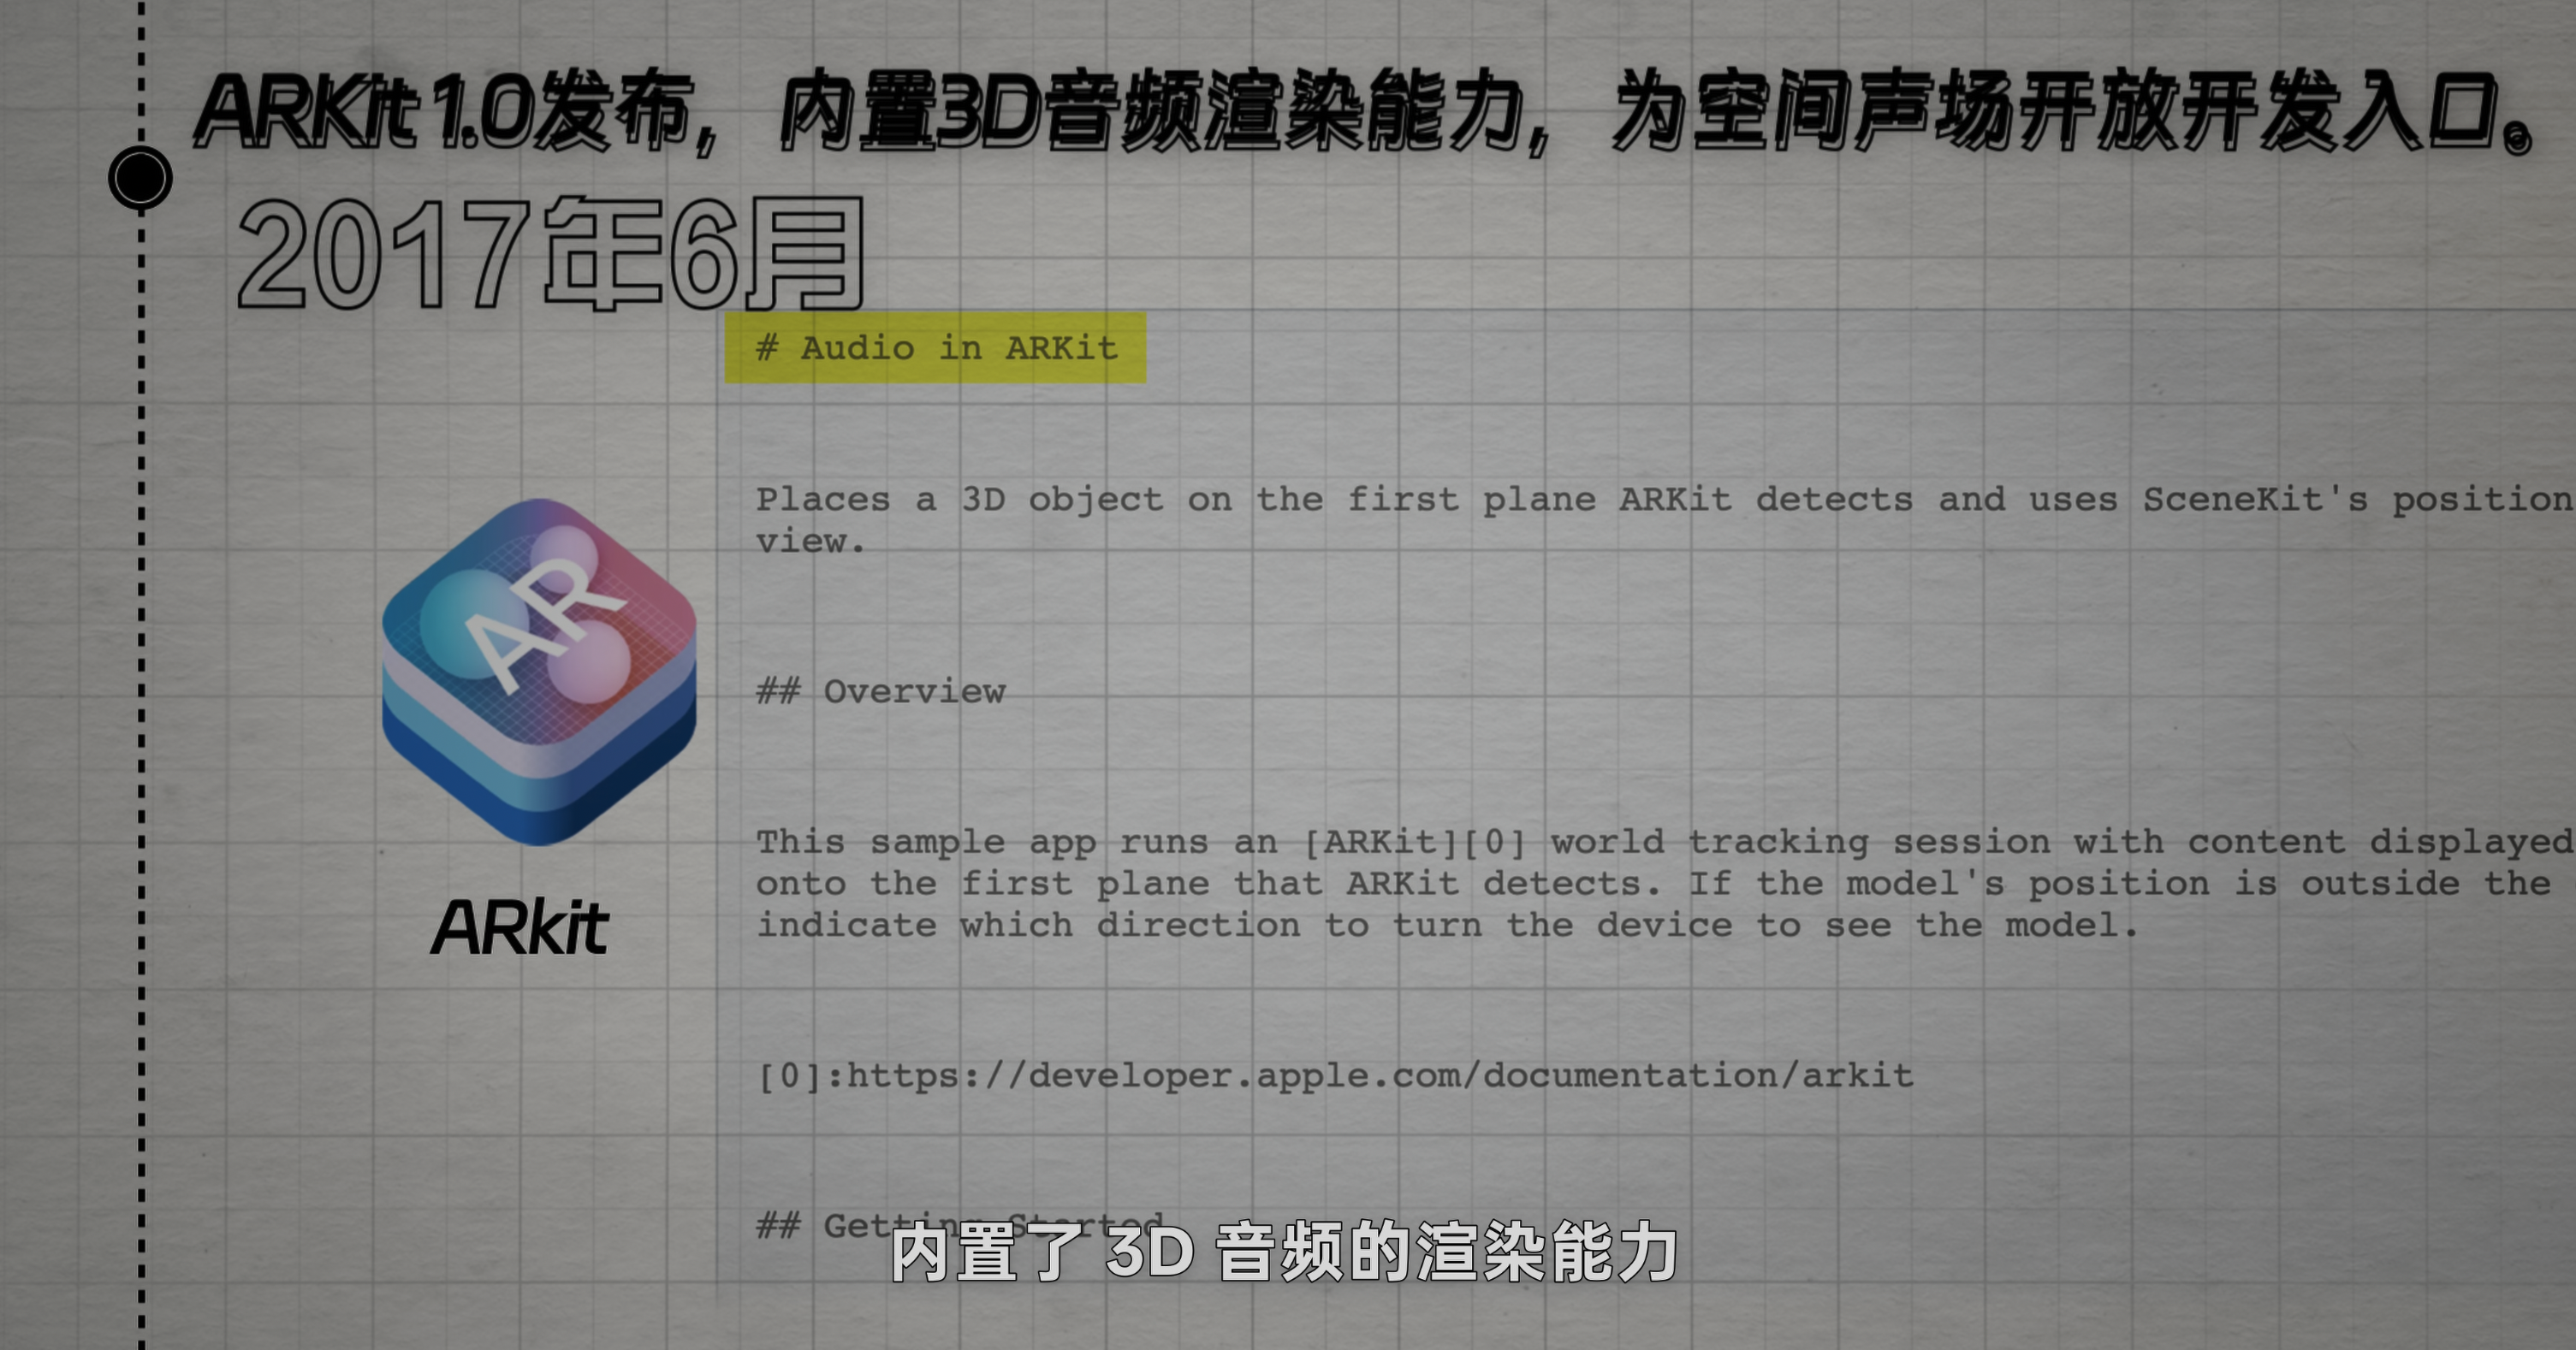
2017 年,ARKit 1.0 发布。苹果在增强现实框架中内置了 3D 音频渲染能力,开发者可以为虚拟物体添加定位音效,声音位置随头部移动而变化,为后续空间声场能力打开了一个公开入口。
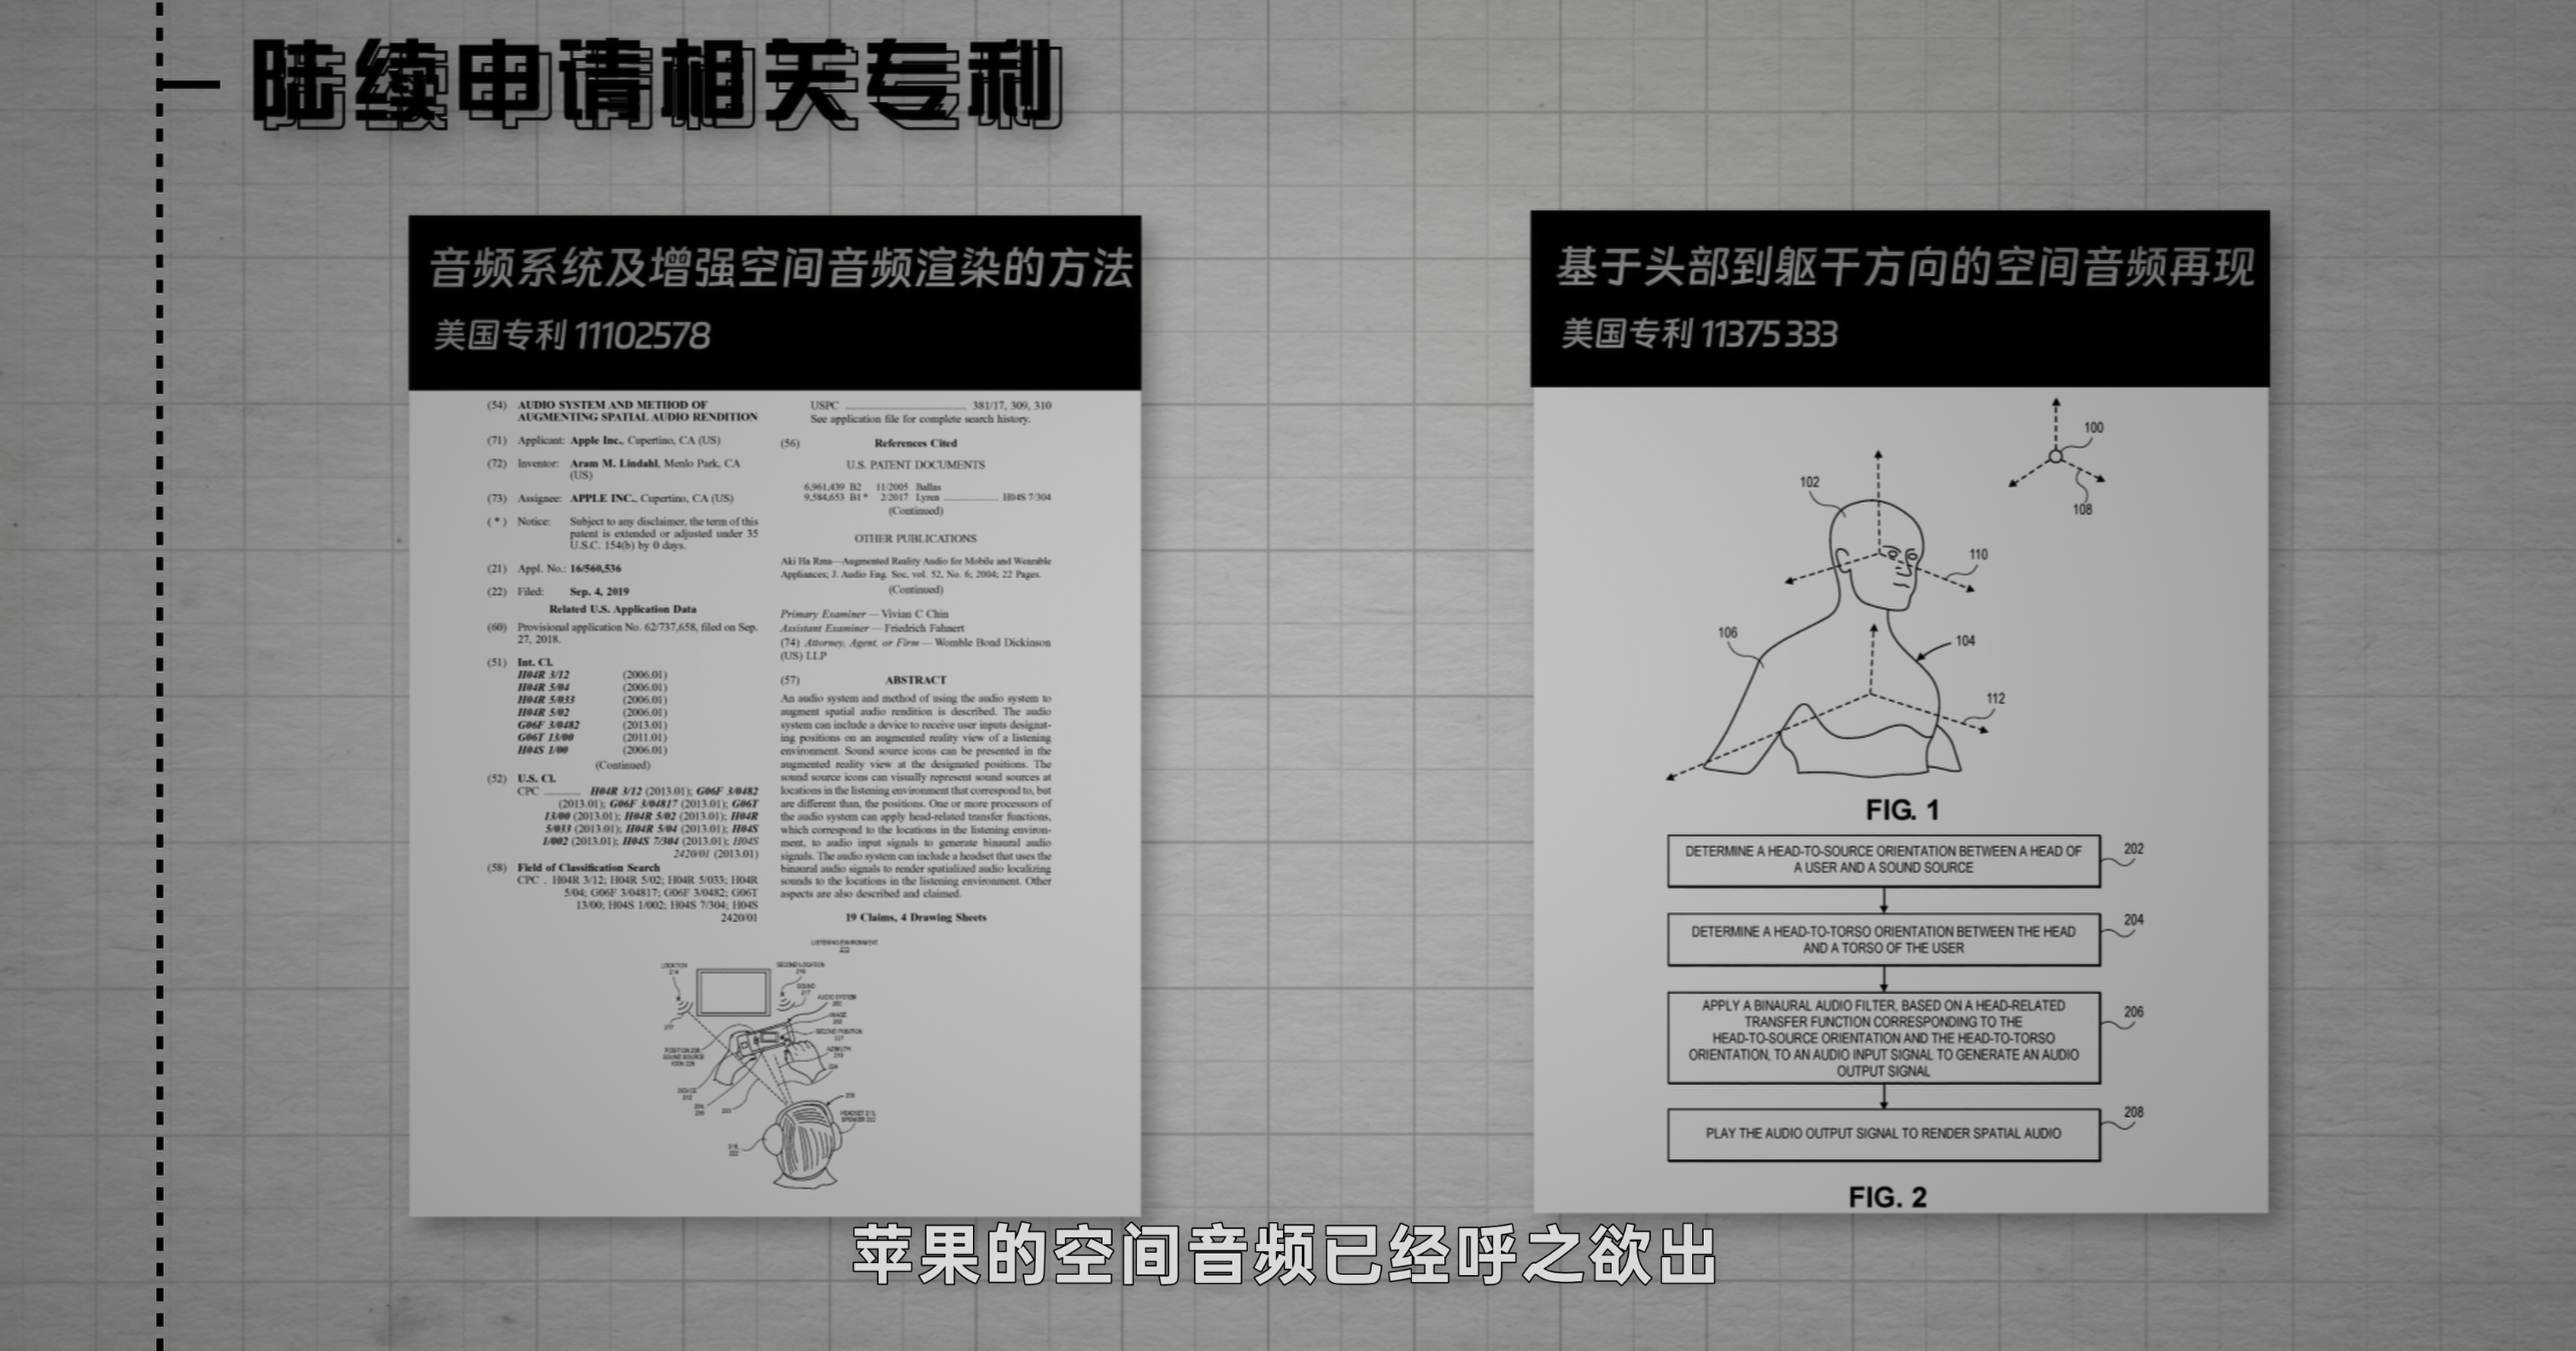
公开记录显示,苹果还在这一时期提交了多项核心专利:包含了 HRTF 的个性化建模以及双耳渲染的实现方法等等。密切关注该领域的人意识到,苹果的空间音频,已经呼之欲出。
2019 年 10 月,AirPods Pro 上市,发布会上没有提到空间音频。但官网详情页揭示了一个事后才显得意味深长的细节:H1 芯片里面内置了加速度计。而问及原因时,苹果当时闪烁其词,显然通透模式和降噪都没有必要获取运动数据。直到一年后,2020 年 6 月,空间音频功能通过固件更新推送给所有 AirPods Pro 用户。
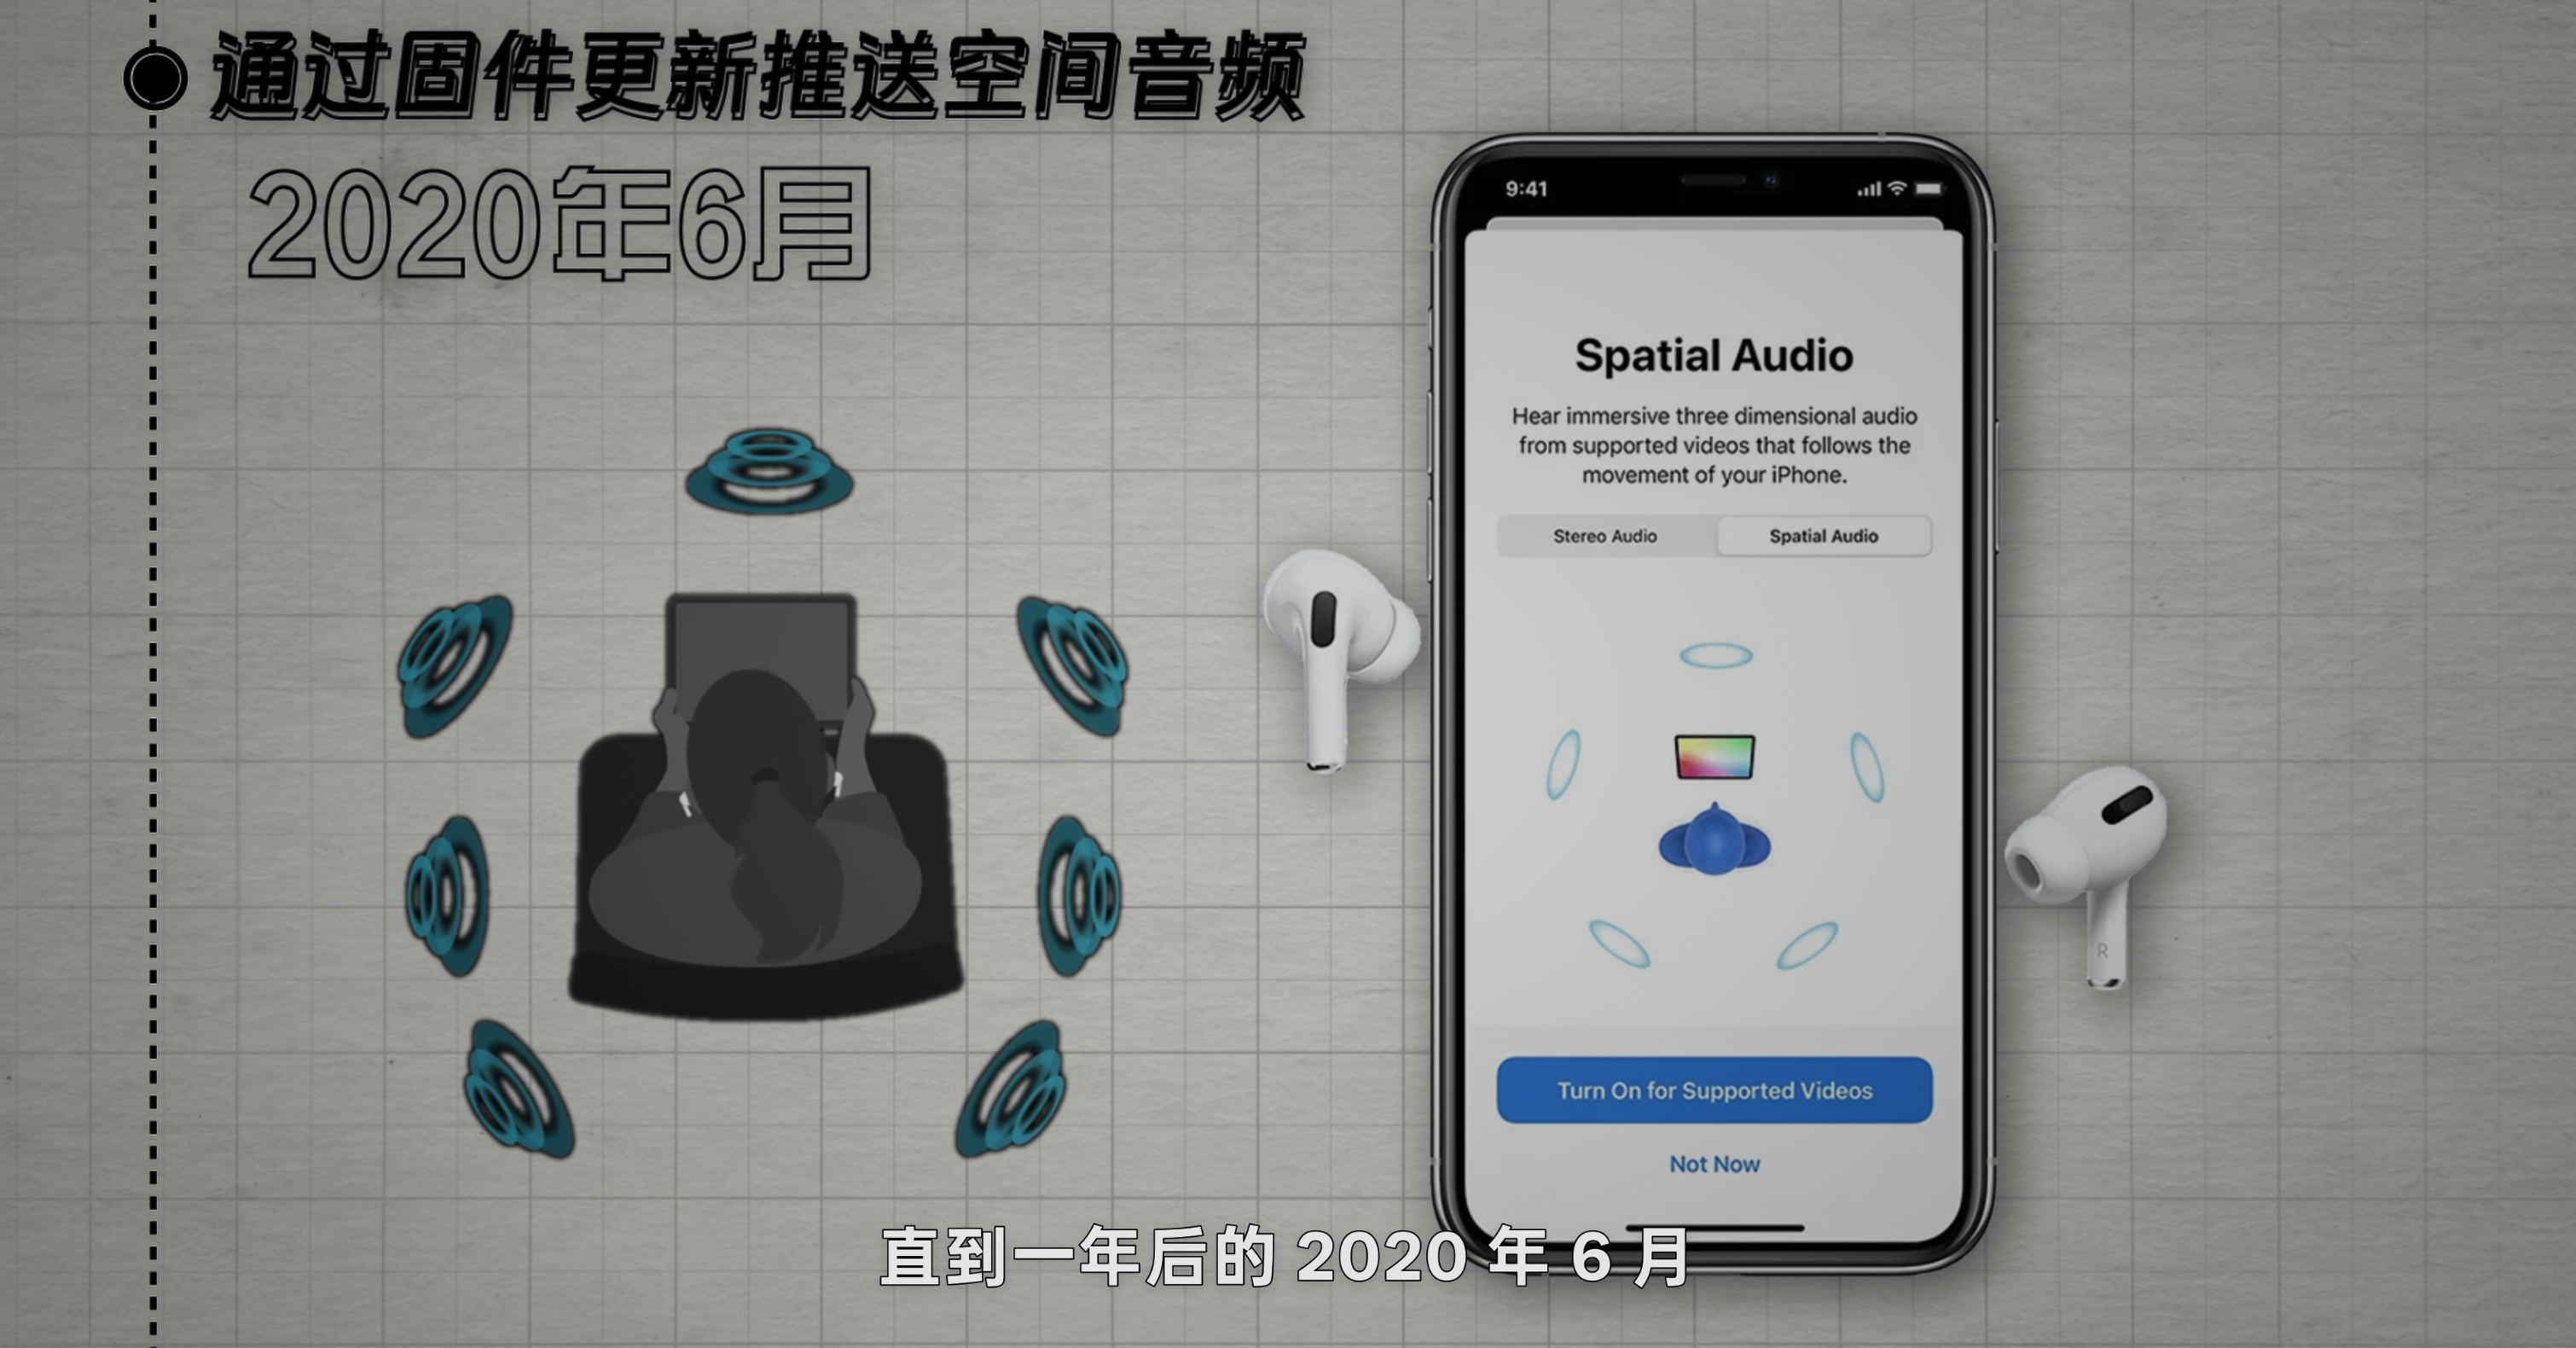
没有新硬件。没有额外付费。功能突然出现在设置菜单里。这一刻,人们才意识到:AirPods Pro 的硬件从来不是为了自动切换准备的。
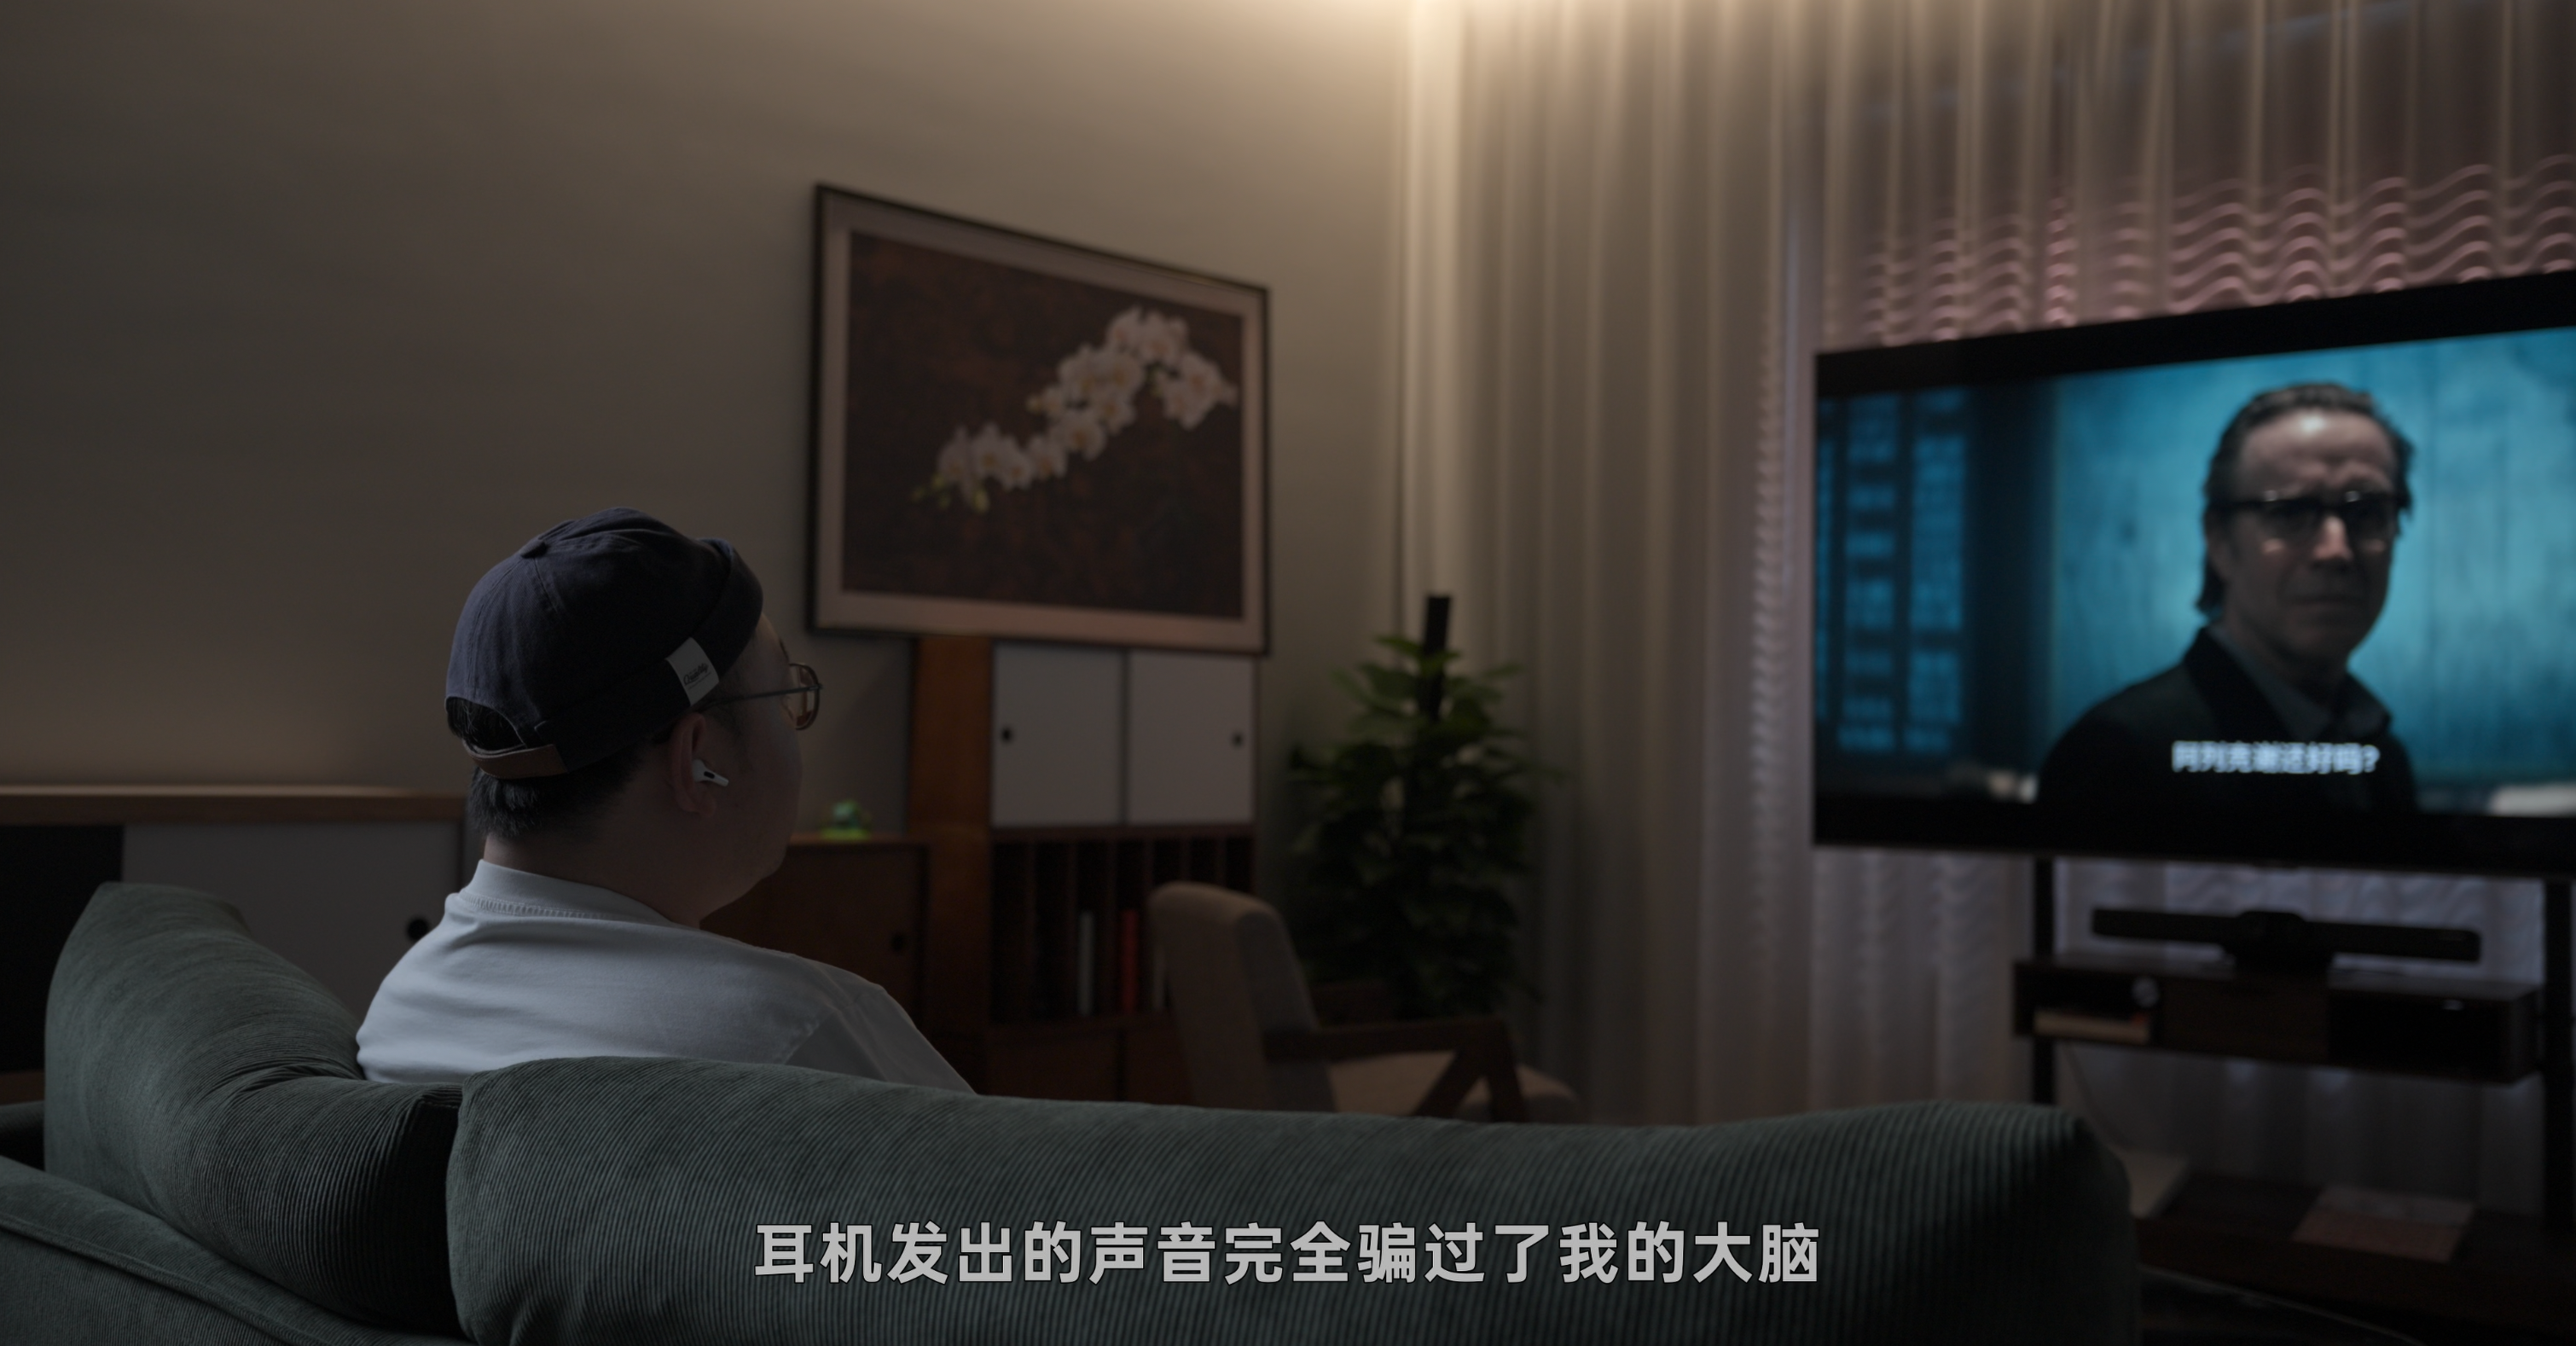
它从一开始就是为空间音频预埋的。这其实不是一个很容易理解的概念,只有你亲自戴上耳机感受,你才能感受到那种奇妙,对于我来说,某一次深夜戴着耳机看电视时,耳机发出的声音完全骗过了我的大脑,以至于我认为电视仍然在响,吓得我赶紧按下暂停,怕打扰到正在休息的家人。
苹果花了五年时间,从收购团队、试验 AR 音频、申请专利、预埋硬件,到最终发布功能。这不是常规的产品开发逻辑,而是底层基础设施的建设周期。
04
30ms与HRTF
空间音频的体验好坏,有一个大多数人感知不到、但工程师反复提及的指标:延迟。
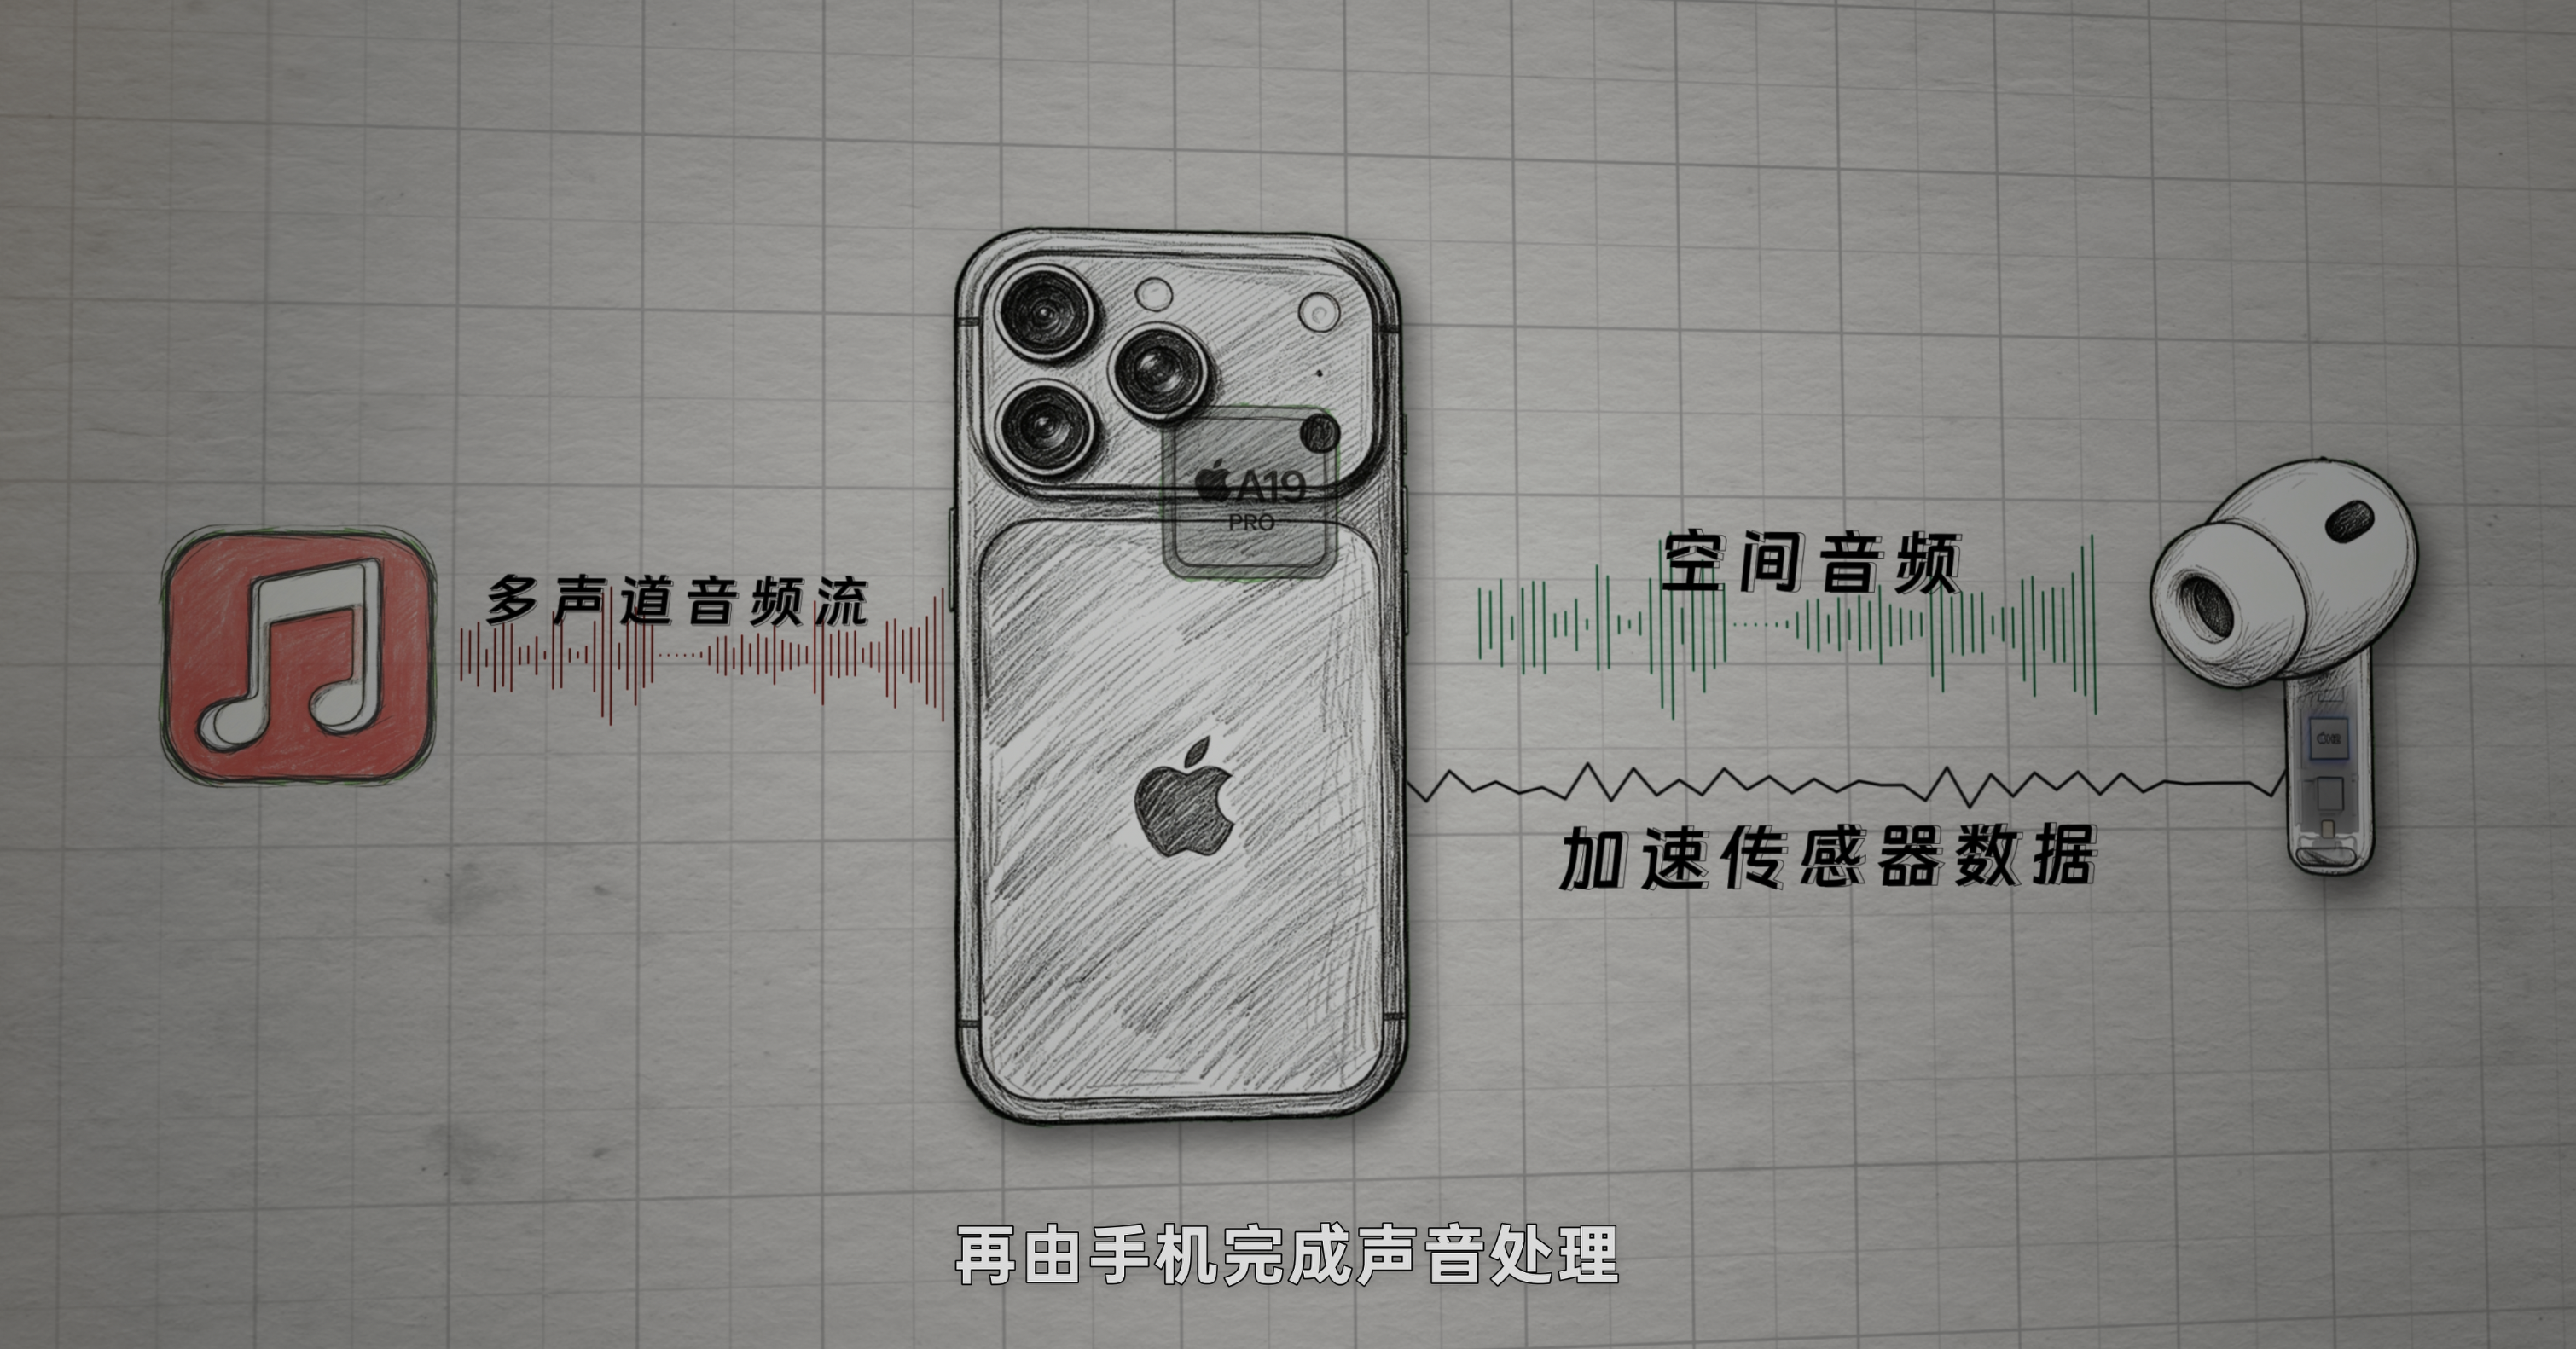
降低延迟为什么难。延迟的来源不光是因为无线通信,更关键的是空间音频整套有点弯弯绕的技术路径,耳机还是那个耳机,但不同的是耳机播放的声音经过了 HRTF 空间化的转换,这个转换的过程只能在手机上完成,耳机的算力和续航完全撑不住,所以整个链路的过程,是耳机将头部姿态的数据传给手机,再由手机完成声音处理,最后传回给耳机。
两次通信,延迟却要优化到比一次更低。
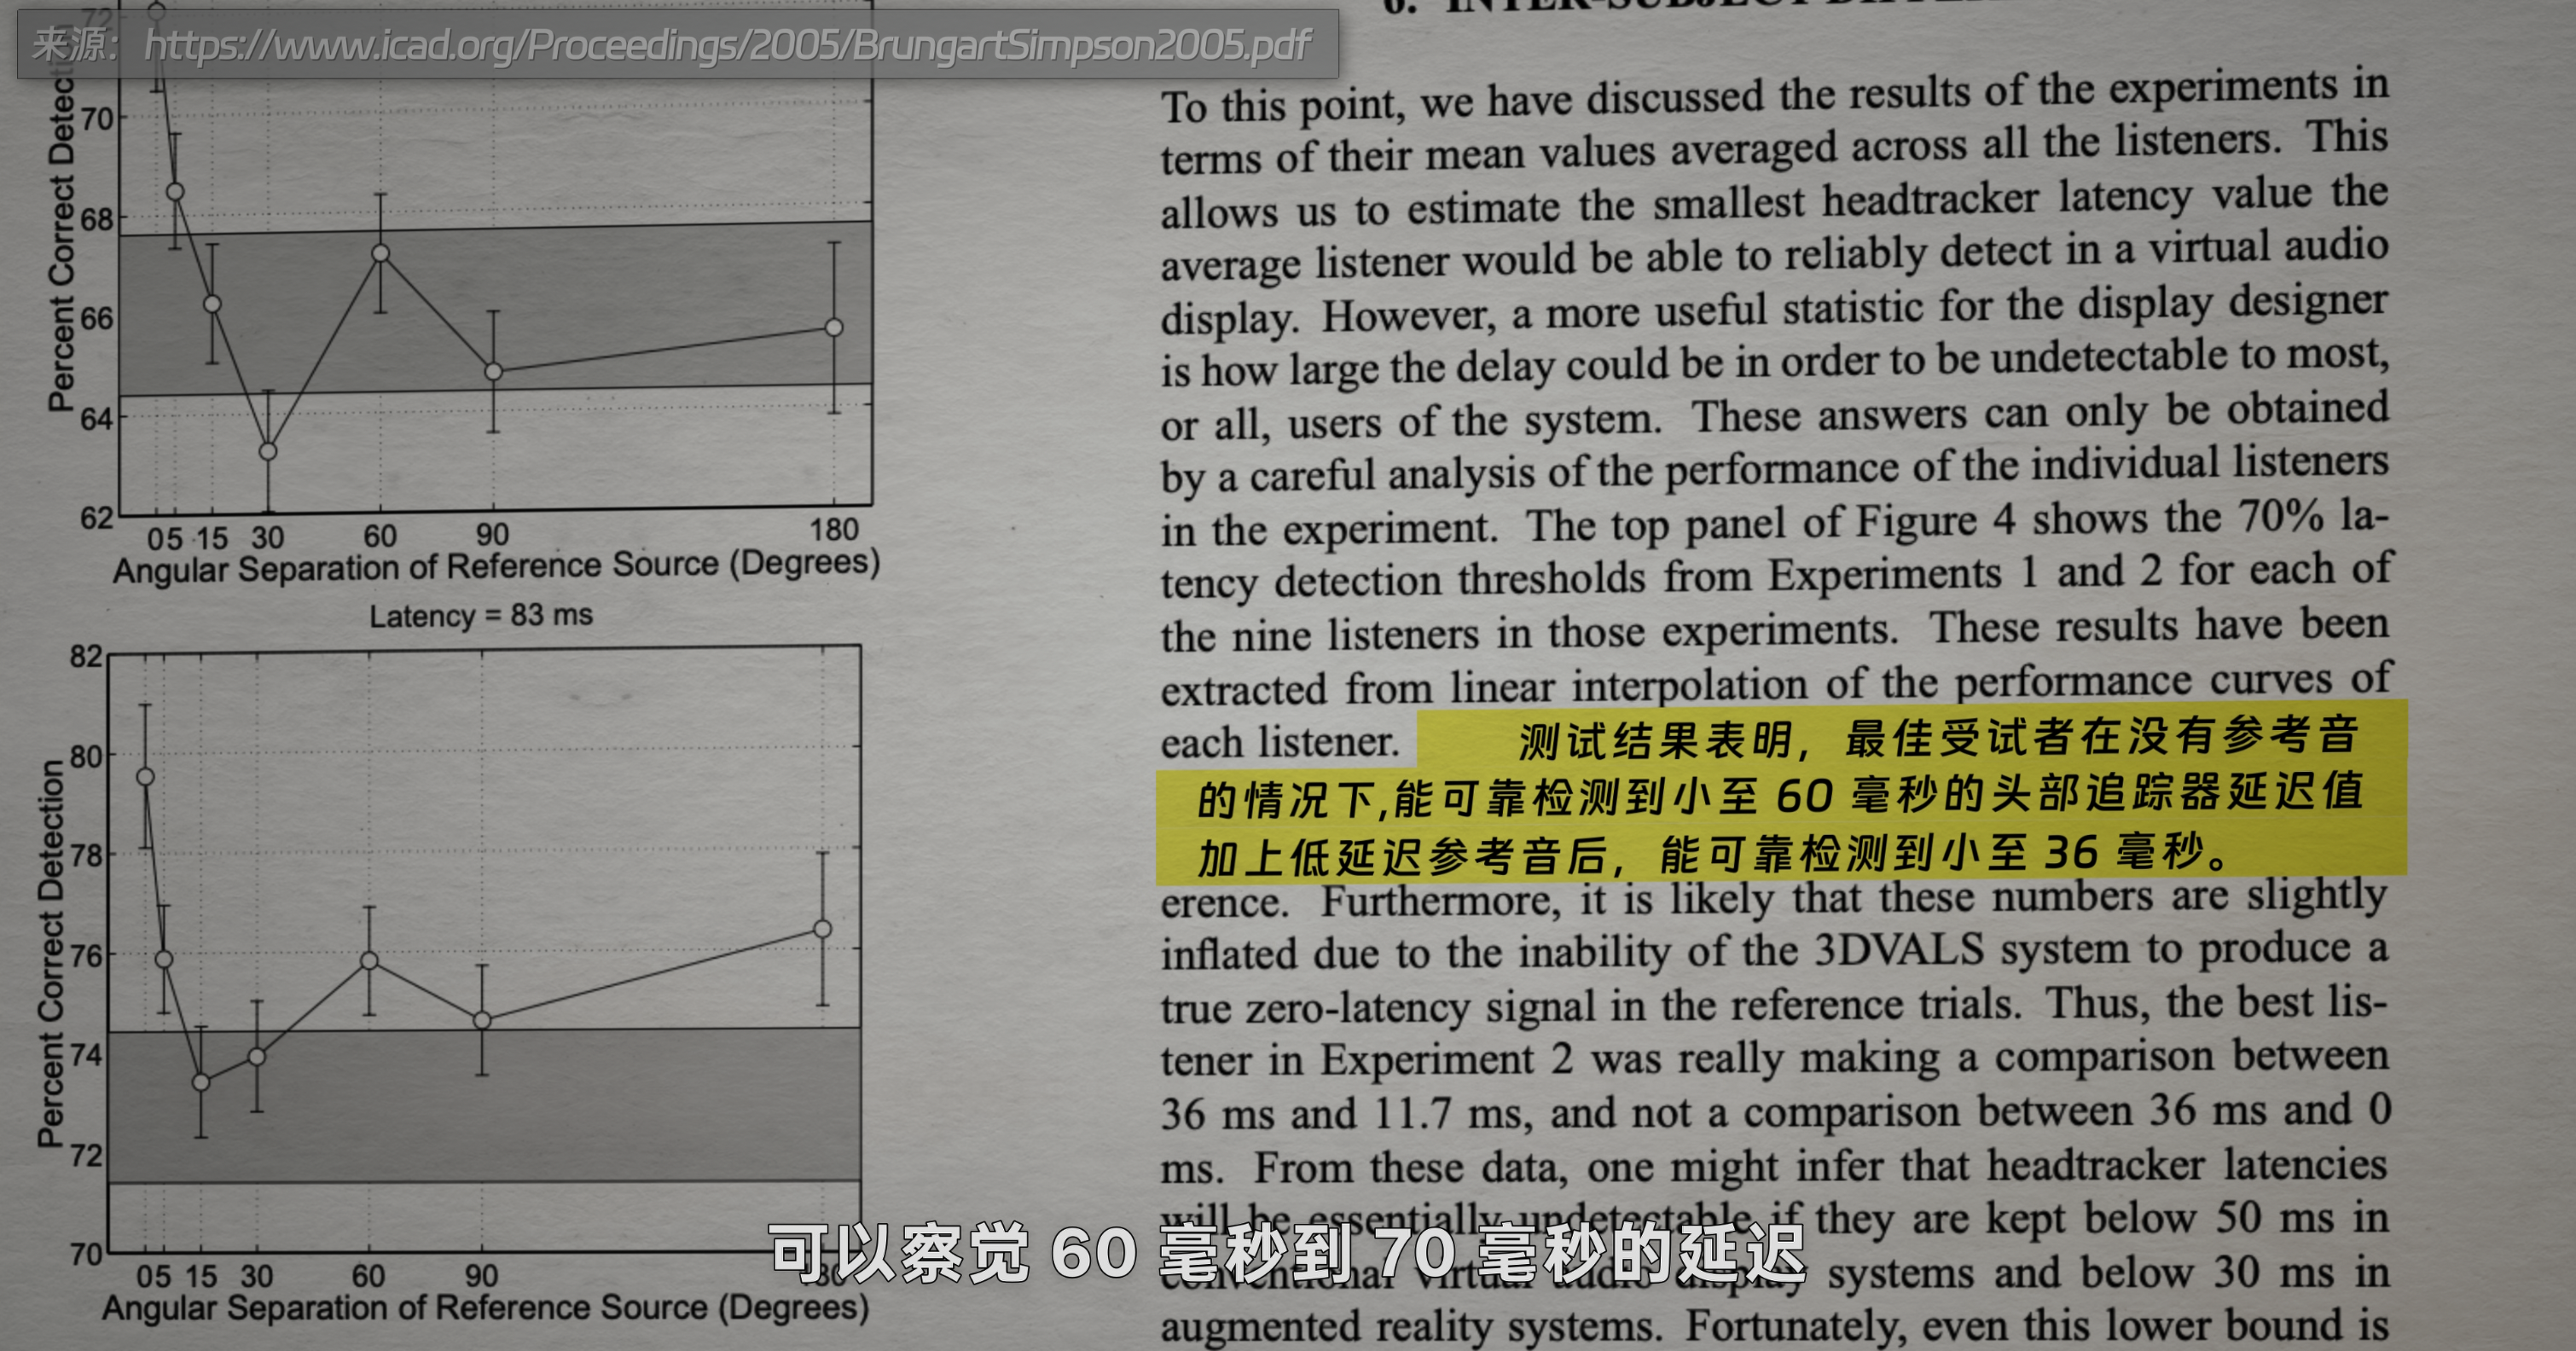
因为延迟是体验的生死线,当头部转动时,声场必须在极短时间内完成重构。行业研究表明,如果延迟超过一定阈值,大脑会察觉声音跟不上头,沉浸感瞬间崩塌,敏感人群可以察觉 60-70ms 的延迟。而在非常苛刻的虚拟听觉环境中,低于 30ms 的延迟才更难被察觉。
在最新的 AirPods Pro 3 上,搭配 Vision Pro 以及低延迟协议,声音传输总体延迟,可以降到 30ms 以内。
苹果能做到这一点,因为它控制了每一个环节,从 AirPods 的传感器采样、蓝牙 LE 的数据传输、iPhone 的渲染计算、再到音频输出的全链路协同。
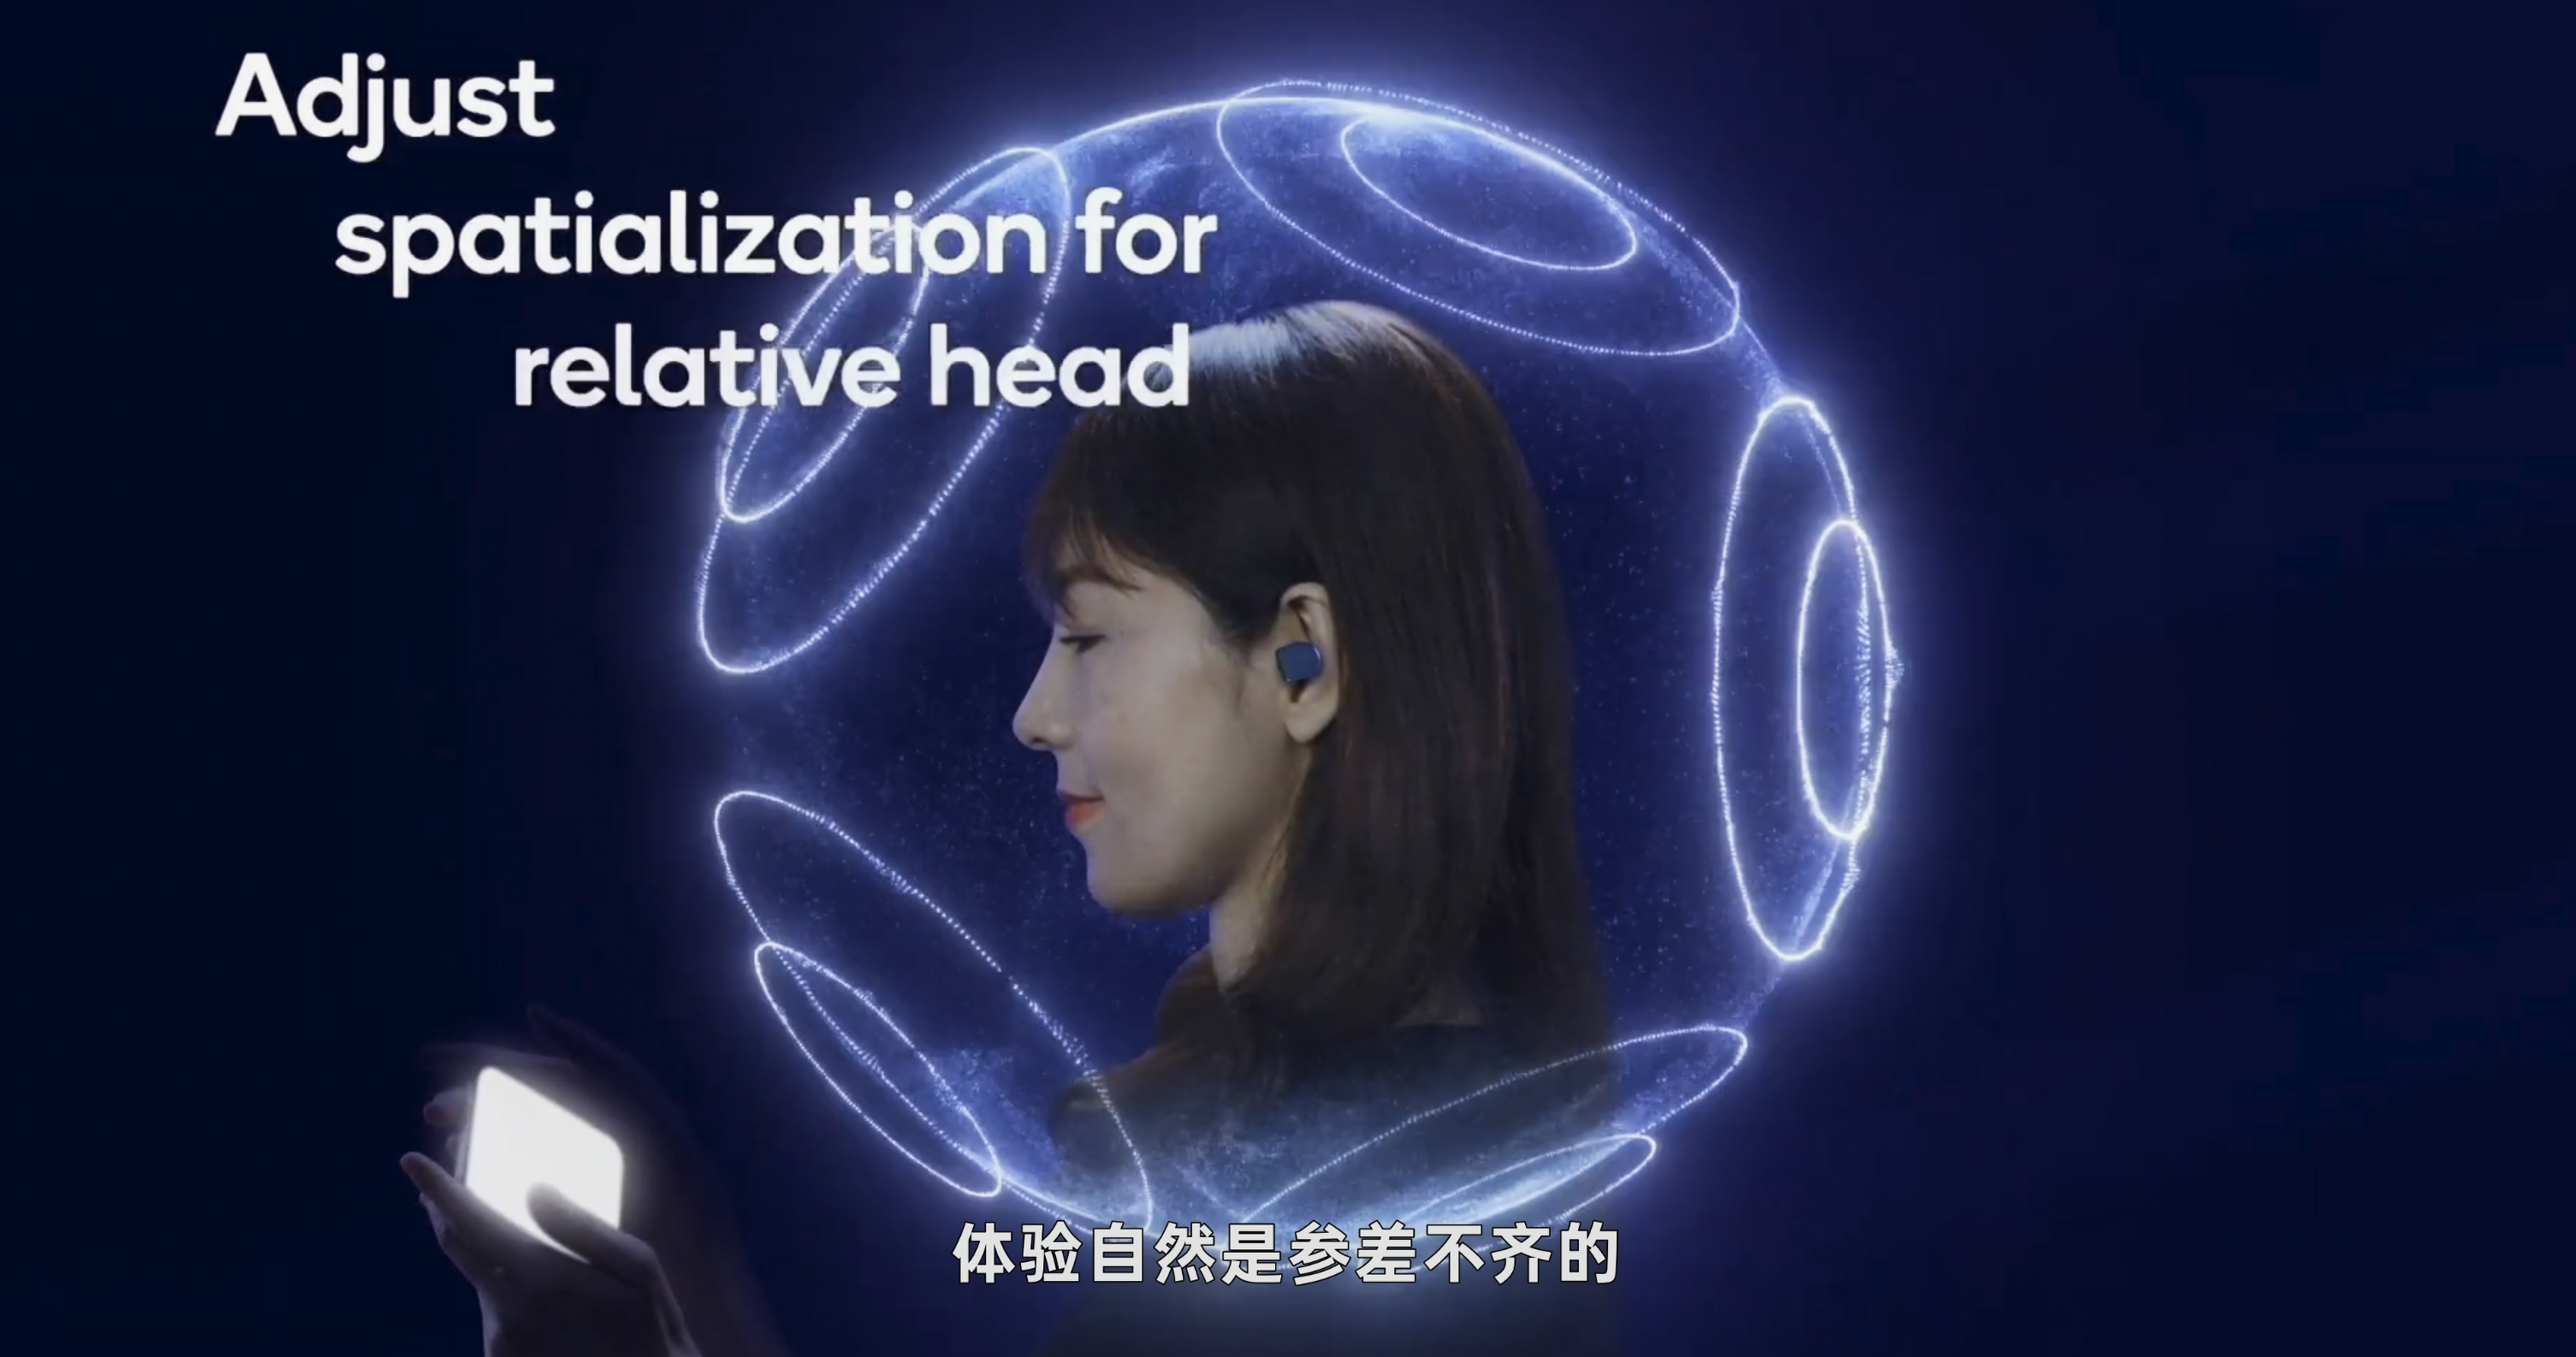
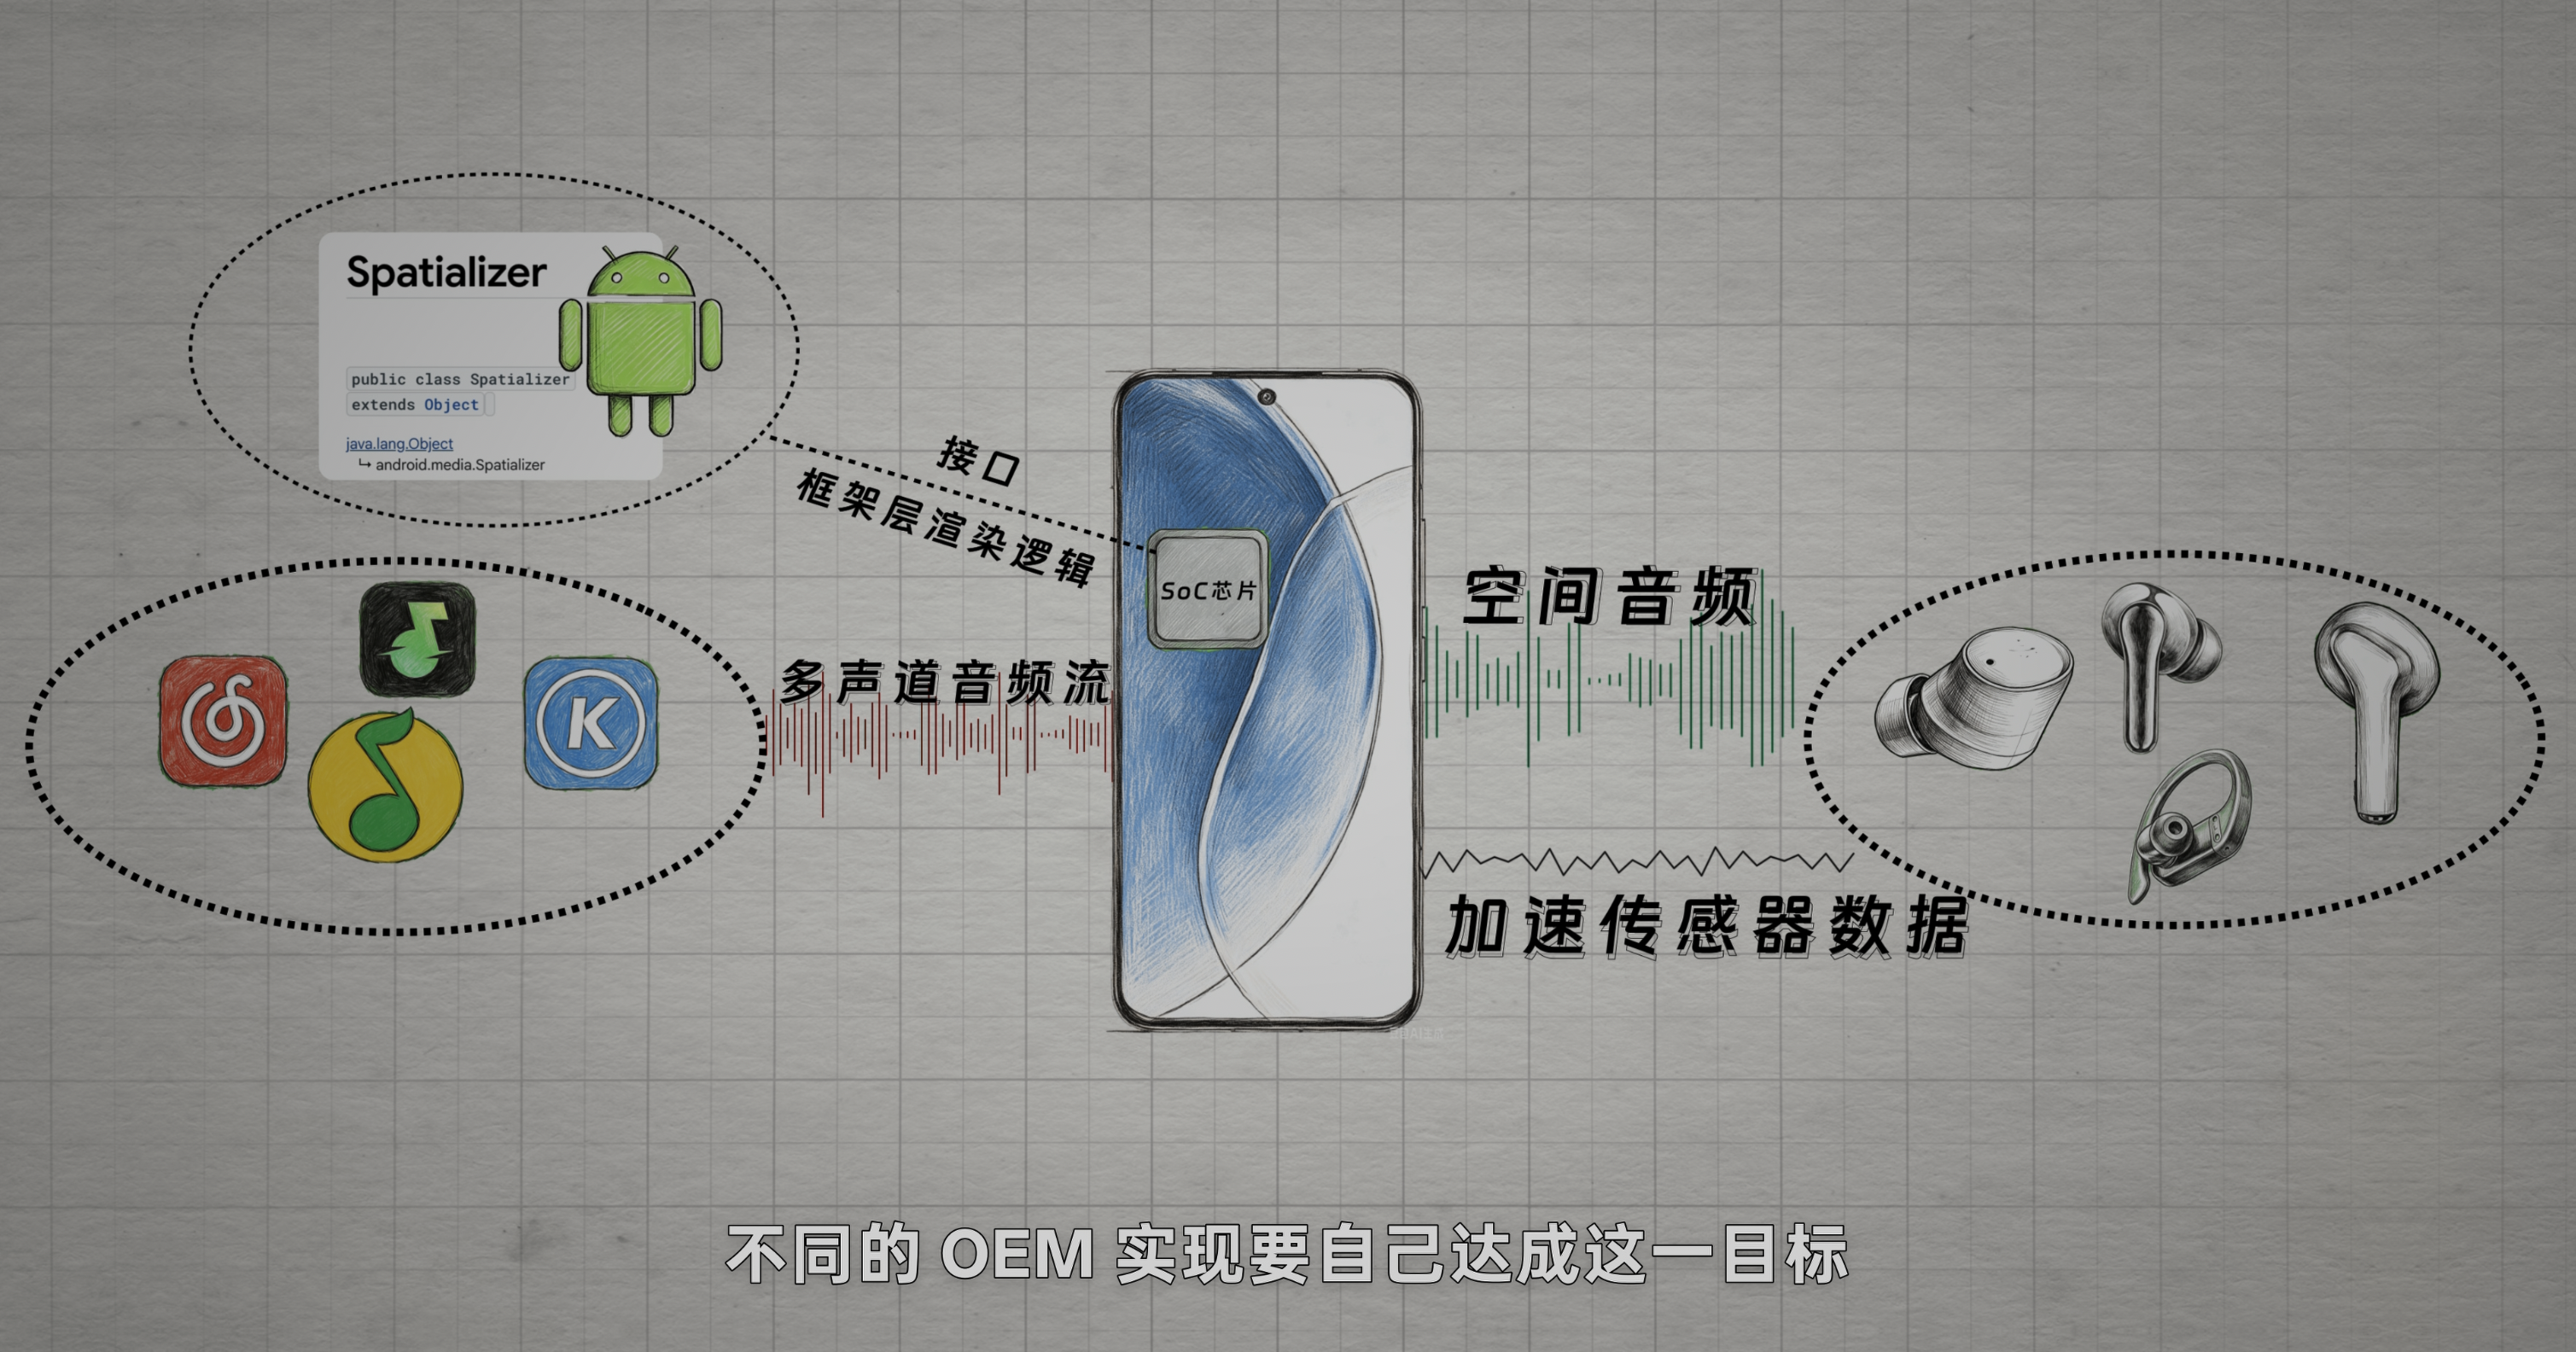
安卓做不到,因为 Google 提供了 API 框架,但传感器选型、渲染算法、编解码方案,由 OEM 各自完成。每个厂商的优化水平不同,体验自然参差不齐。
另一个常被忽略的差异是 HRTF 个性化。
HRTF 因人而异。每个人的耳廓形状、头部尺寸、耳道结构都不同,导致声音在到达鼓膜前的滤波特性千差万别。使用通用 HRTF 模型,相当于给所有人配同一副眼镜——能看,但不准。
苹果的解法,是让用户用 iPhone FaceID 的原深感摄像头扫描用户的耳廓。
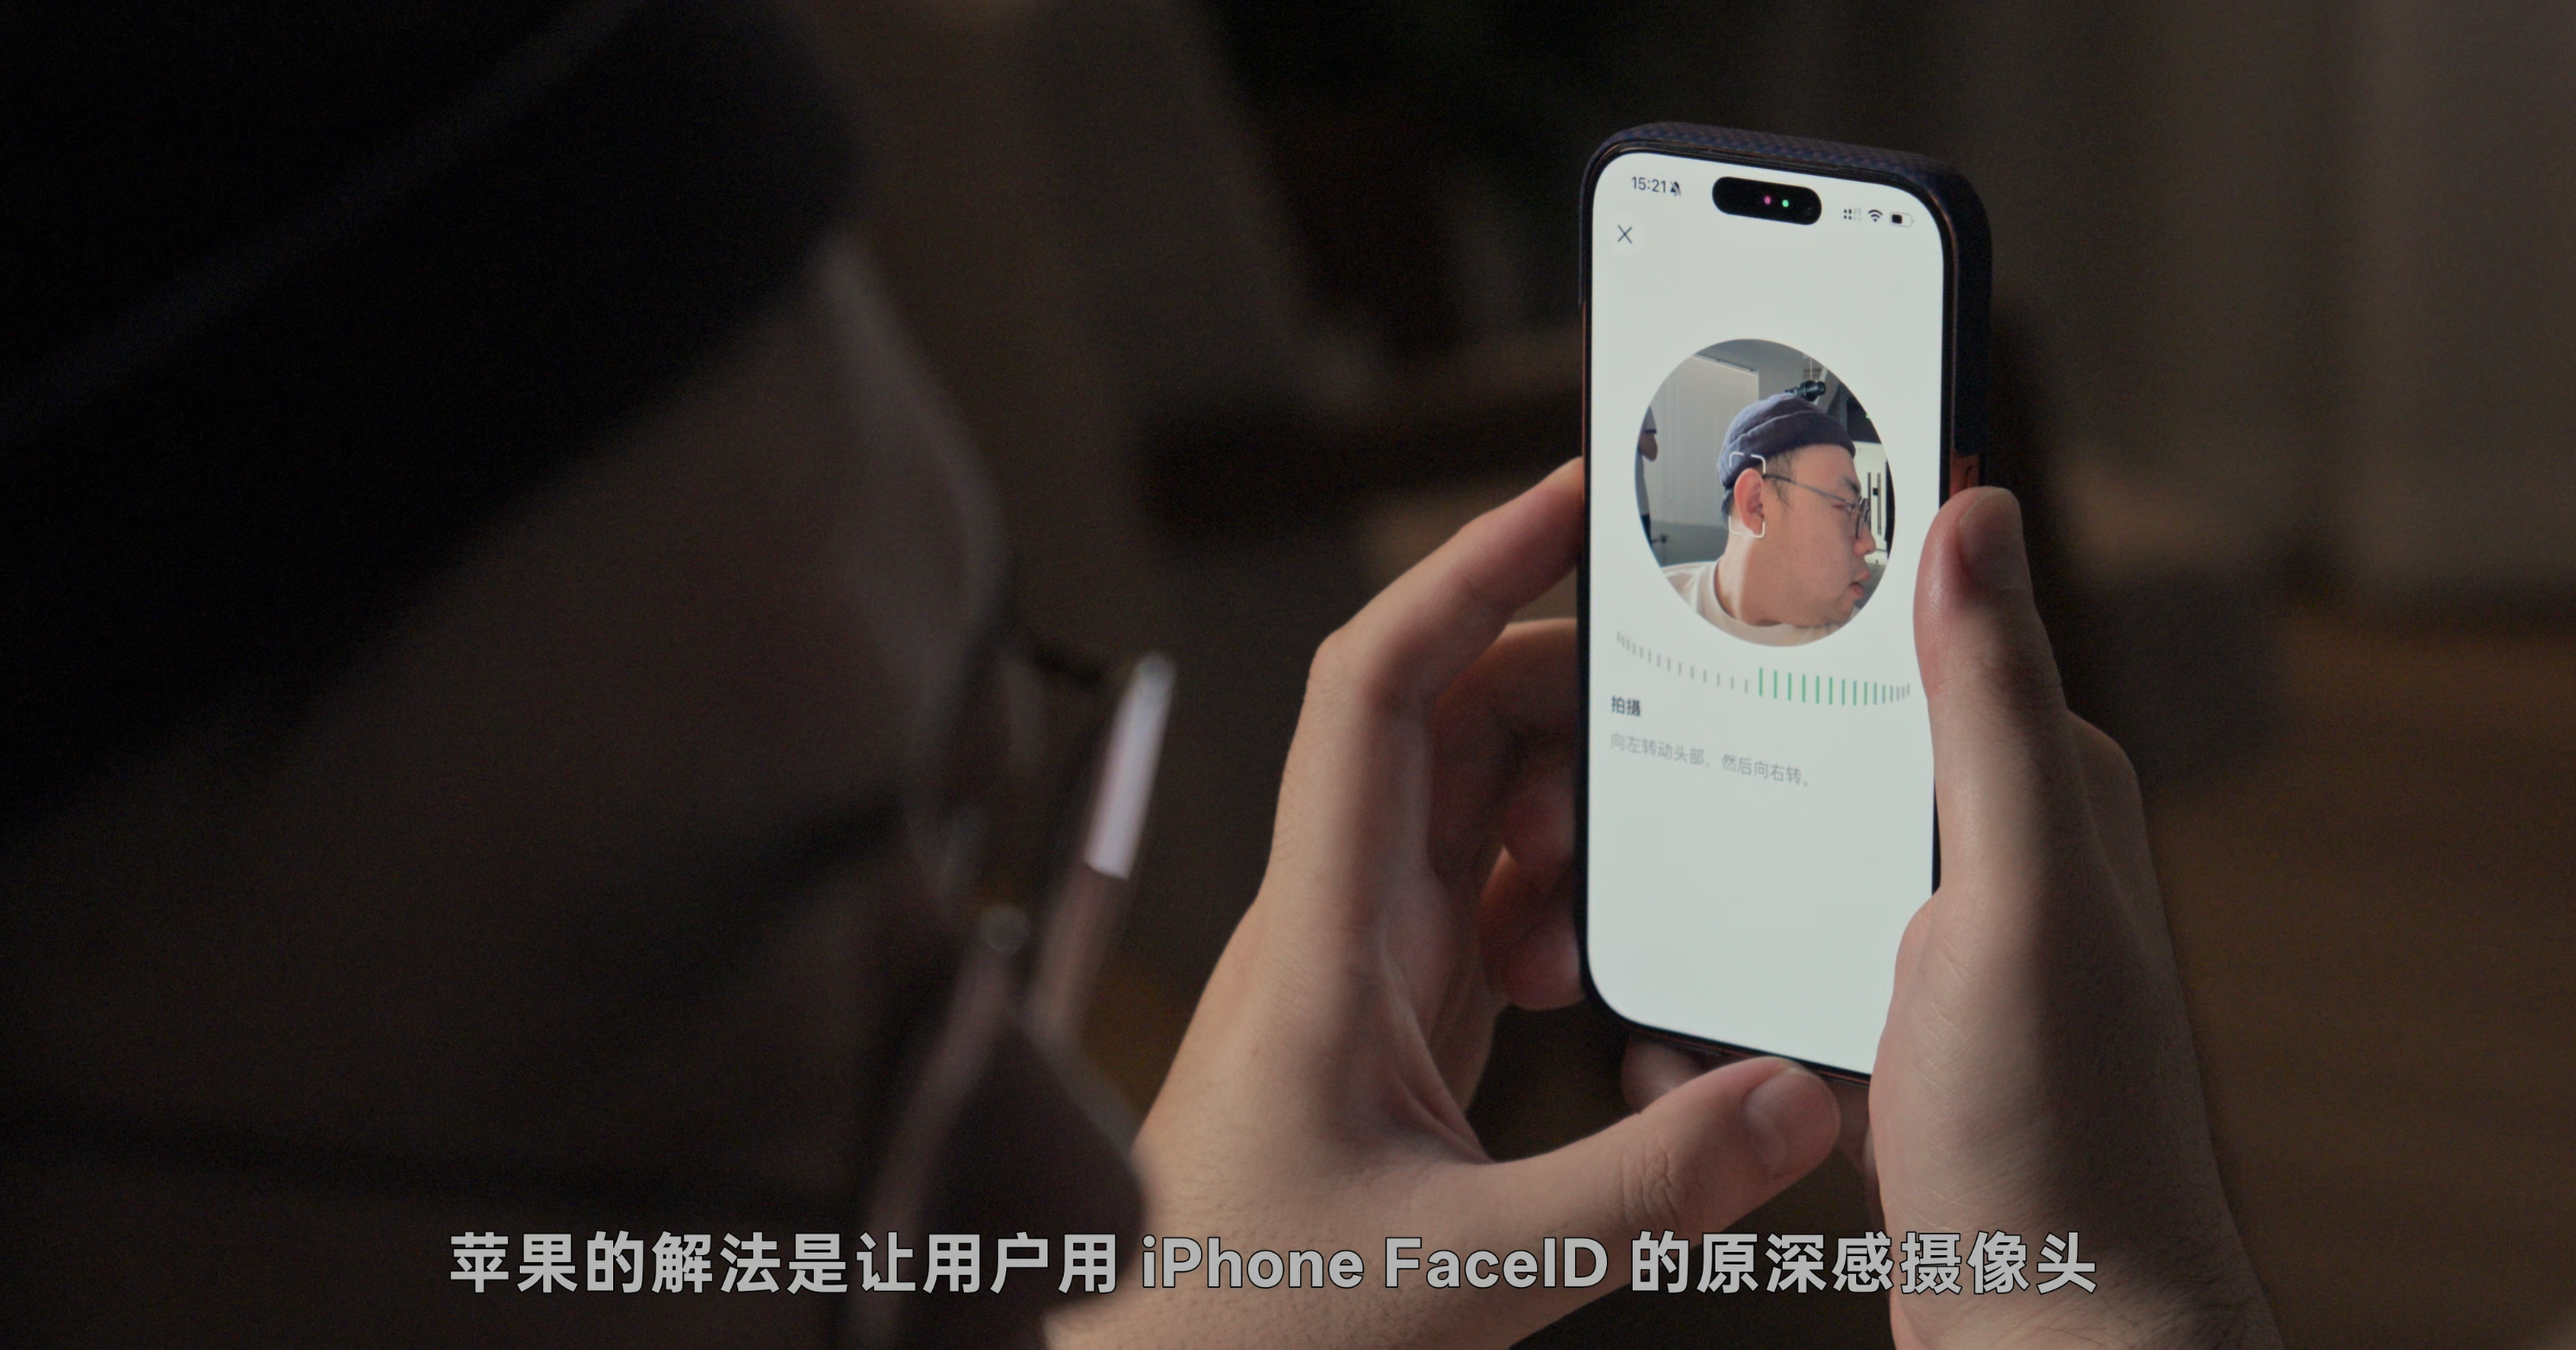
苹果的结构光既然能做到精准识别人脸,那也能同样扫描耳廓。
WWDC 2022 的一场技术 Session 详细解释了这套流程。苹果的工程师没有公开具体的架构,但强调了一个结果:基于机器学习的个性化 HRTF 的匹配精度,显著优于基于统计平均的通用模型。安卓阵营中,几乎没有厂商提供同等级别的个性化方案。
多数产品依赖简单的问卷或直接采用通用模型。这不是态度问题,是架构问题——FaceID 本身就是另一座技术的大山,你没有前置的技术储备,没有存量机型的硬件铺垫,我们看到的更多是结果,但体验的胜负可能在很多年之前就早早的确定了。
,Apple Music 里的杜比全景声内容是自己谈下来的。
05
安卓体验的鸿沟
2022 年,Google 在 Android 13 中引入了原生的空间音频框架 Spatializer API。这是一个标志——安卓阵营终于开始系统性跟进。
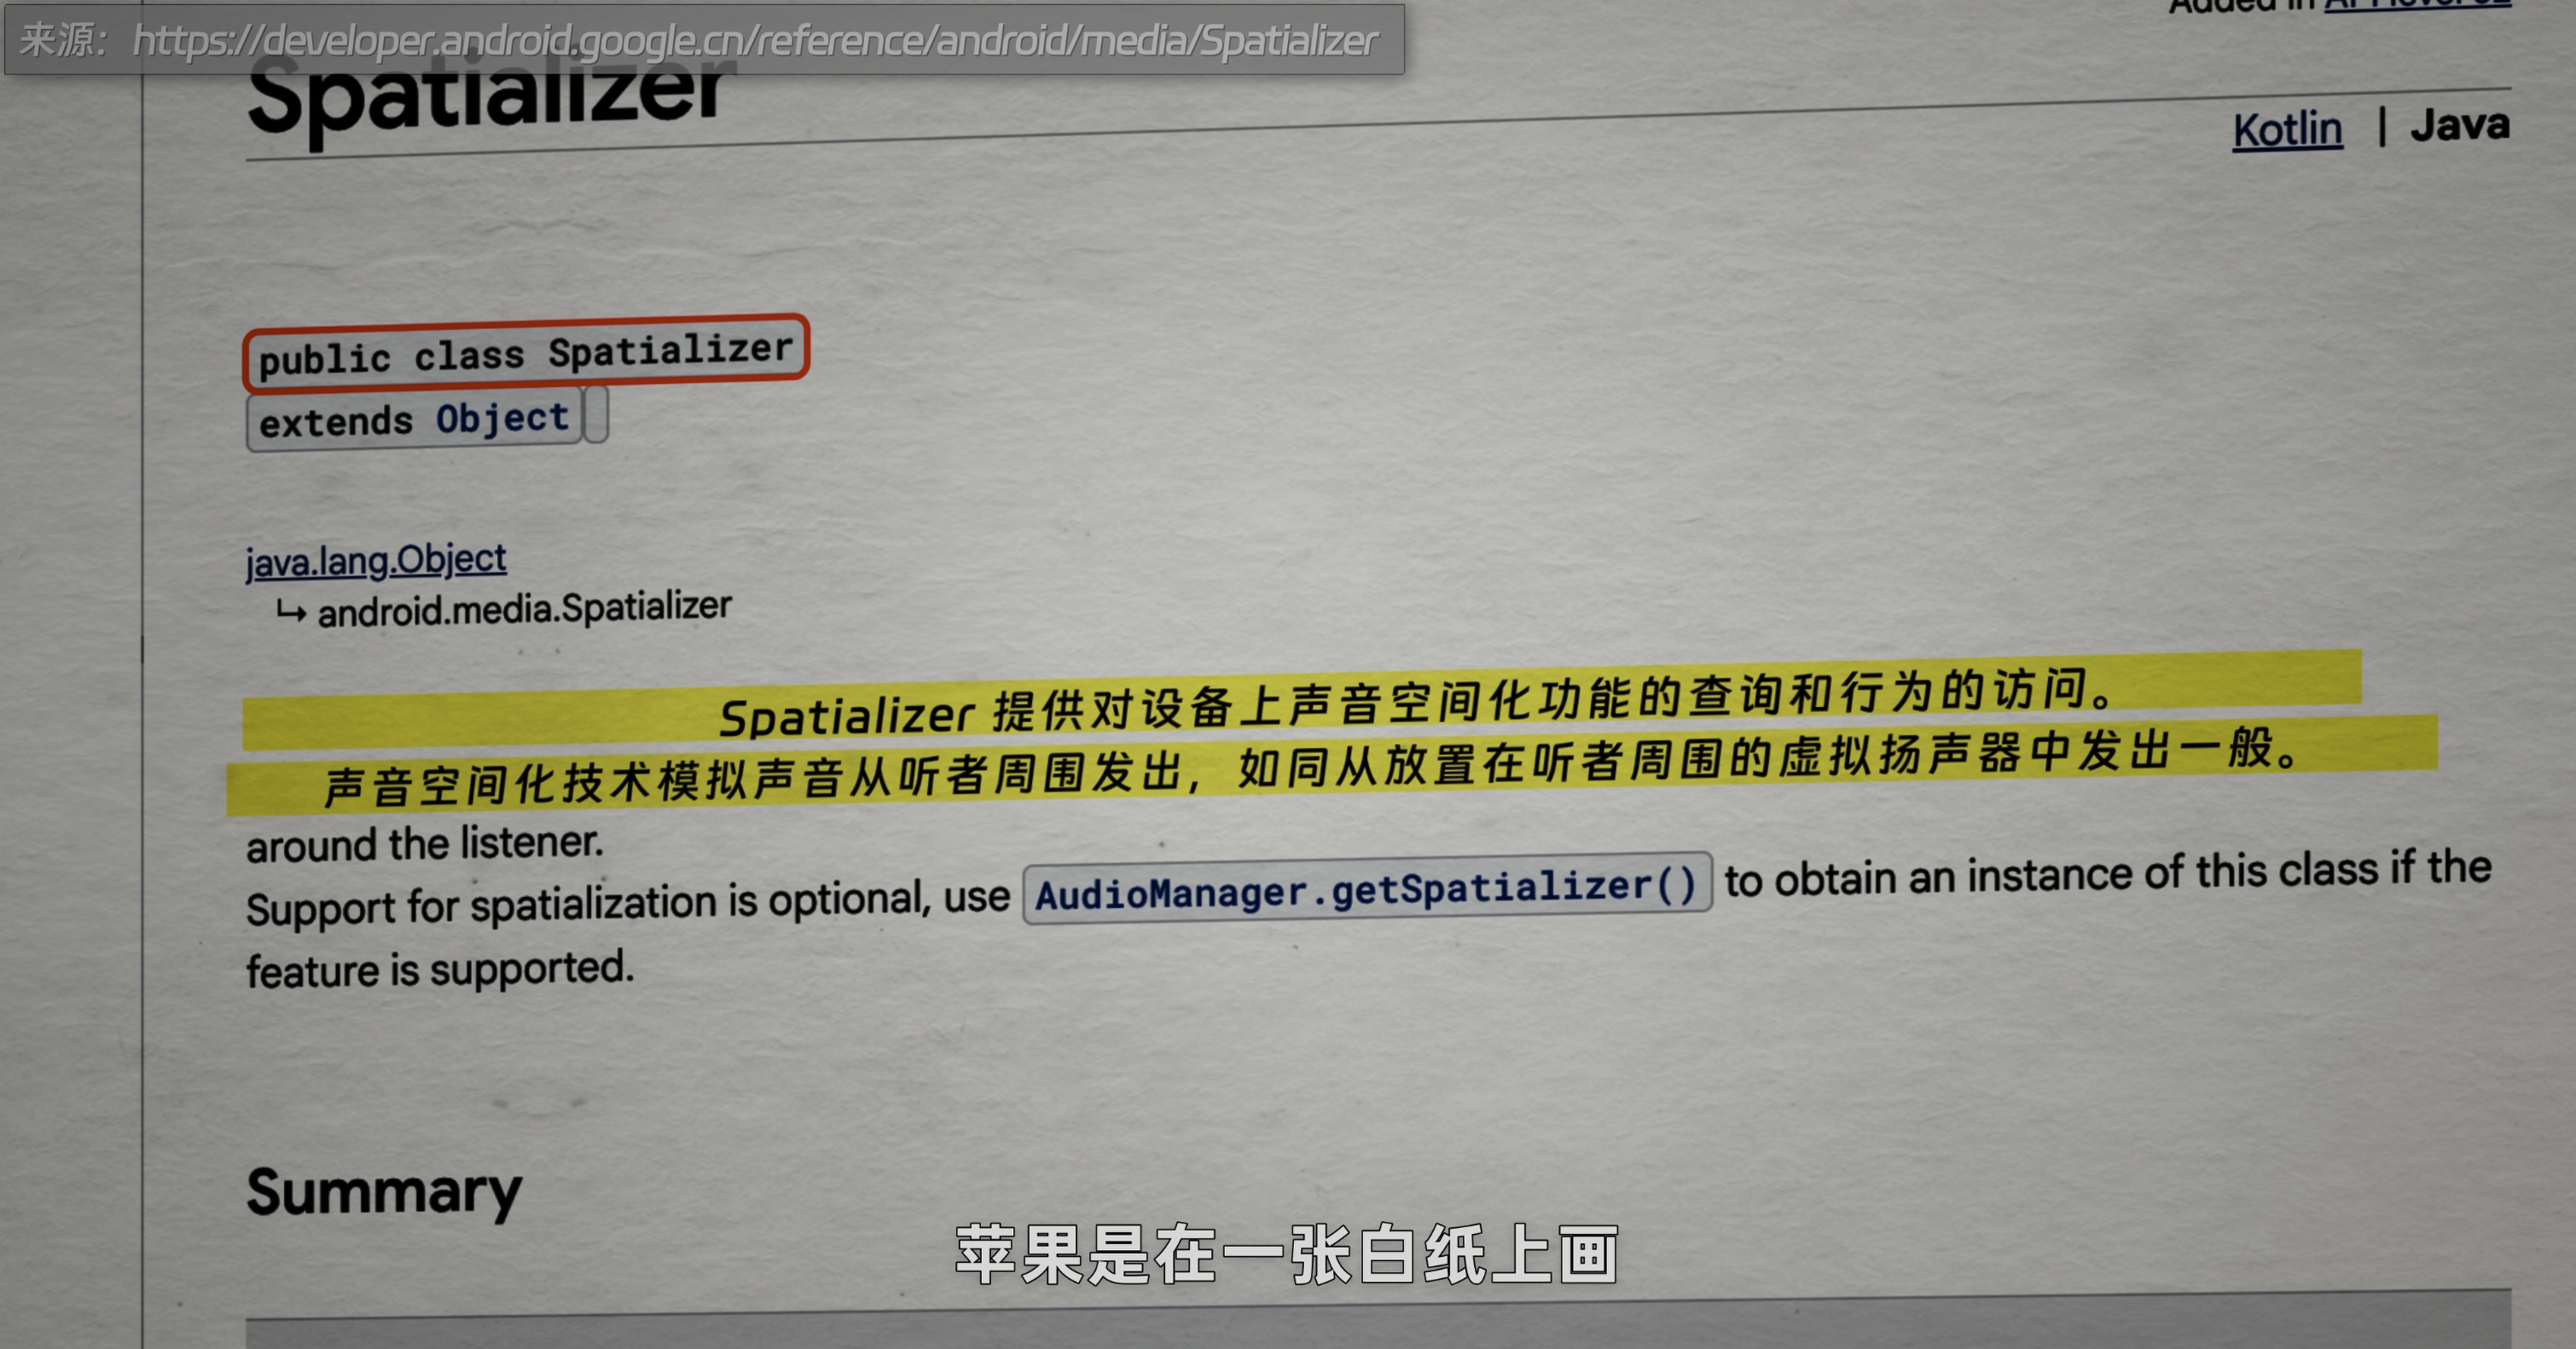
但跟进不等于追平。苹果是在一张白纸上画,安卓是在一张已经画满东西的纸上改。
安卓的路线:Google 提供 API 标准,高通提供芯片方案,手机厂商各自集成耳机,音乐 App 自行适配。每个环节都是不同的公司在做,标准一致但实现各异。不同 OEM 实现要自己达成这一目标。部分场景下,用户能明显感觉到声场慢了半拍。
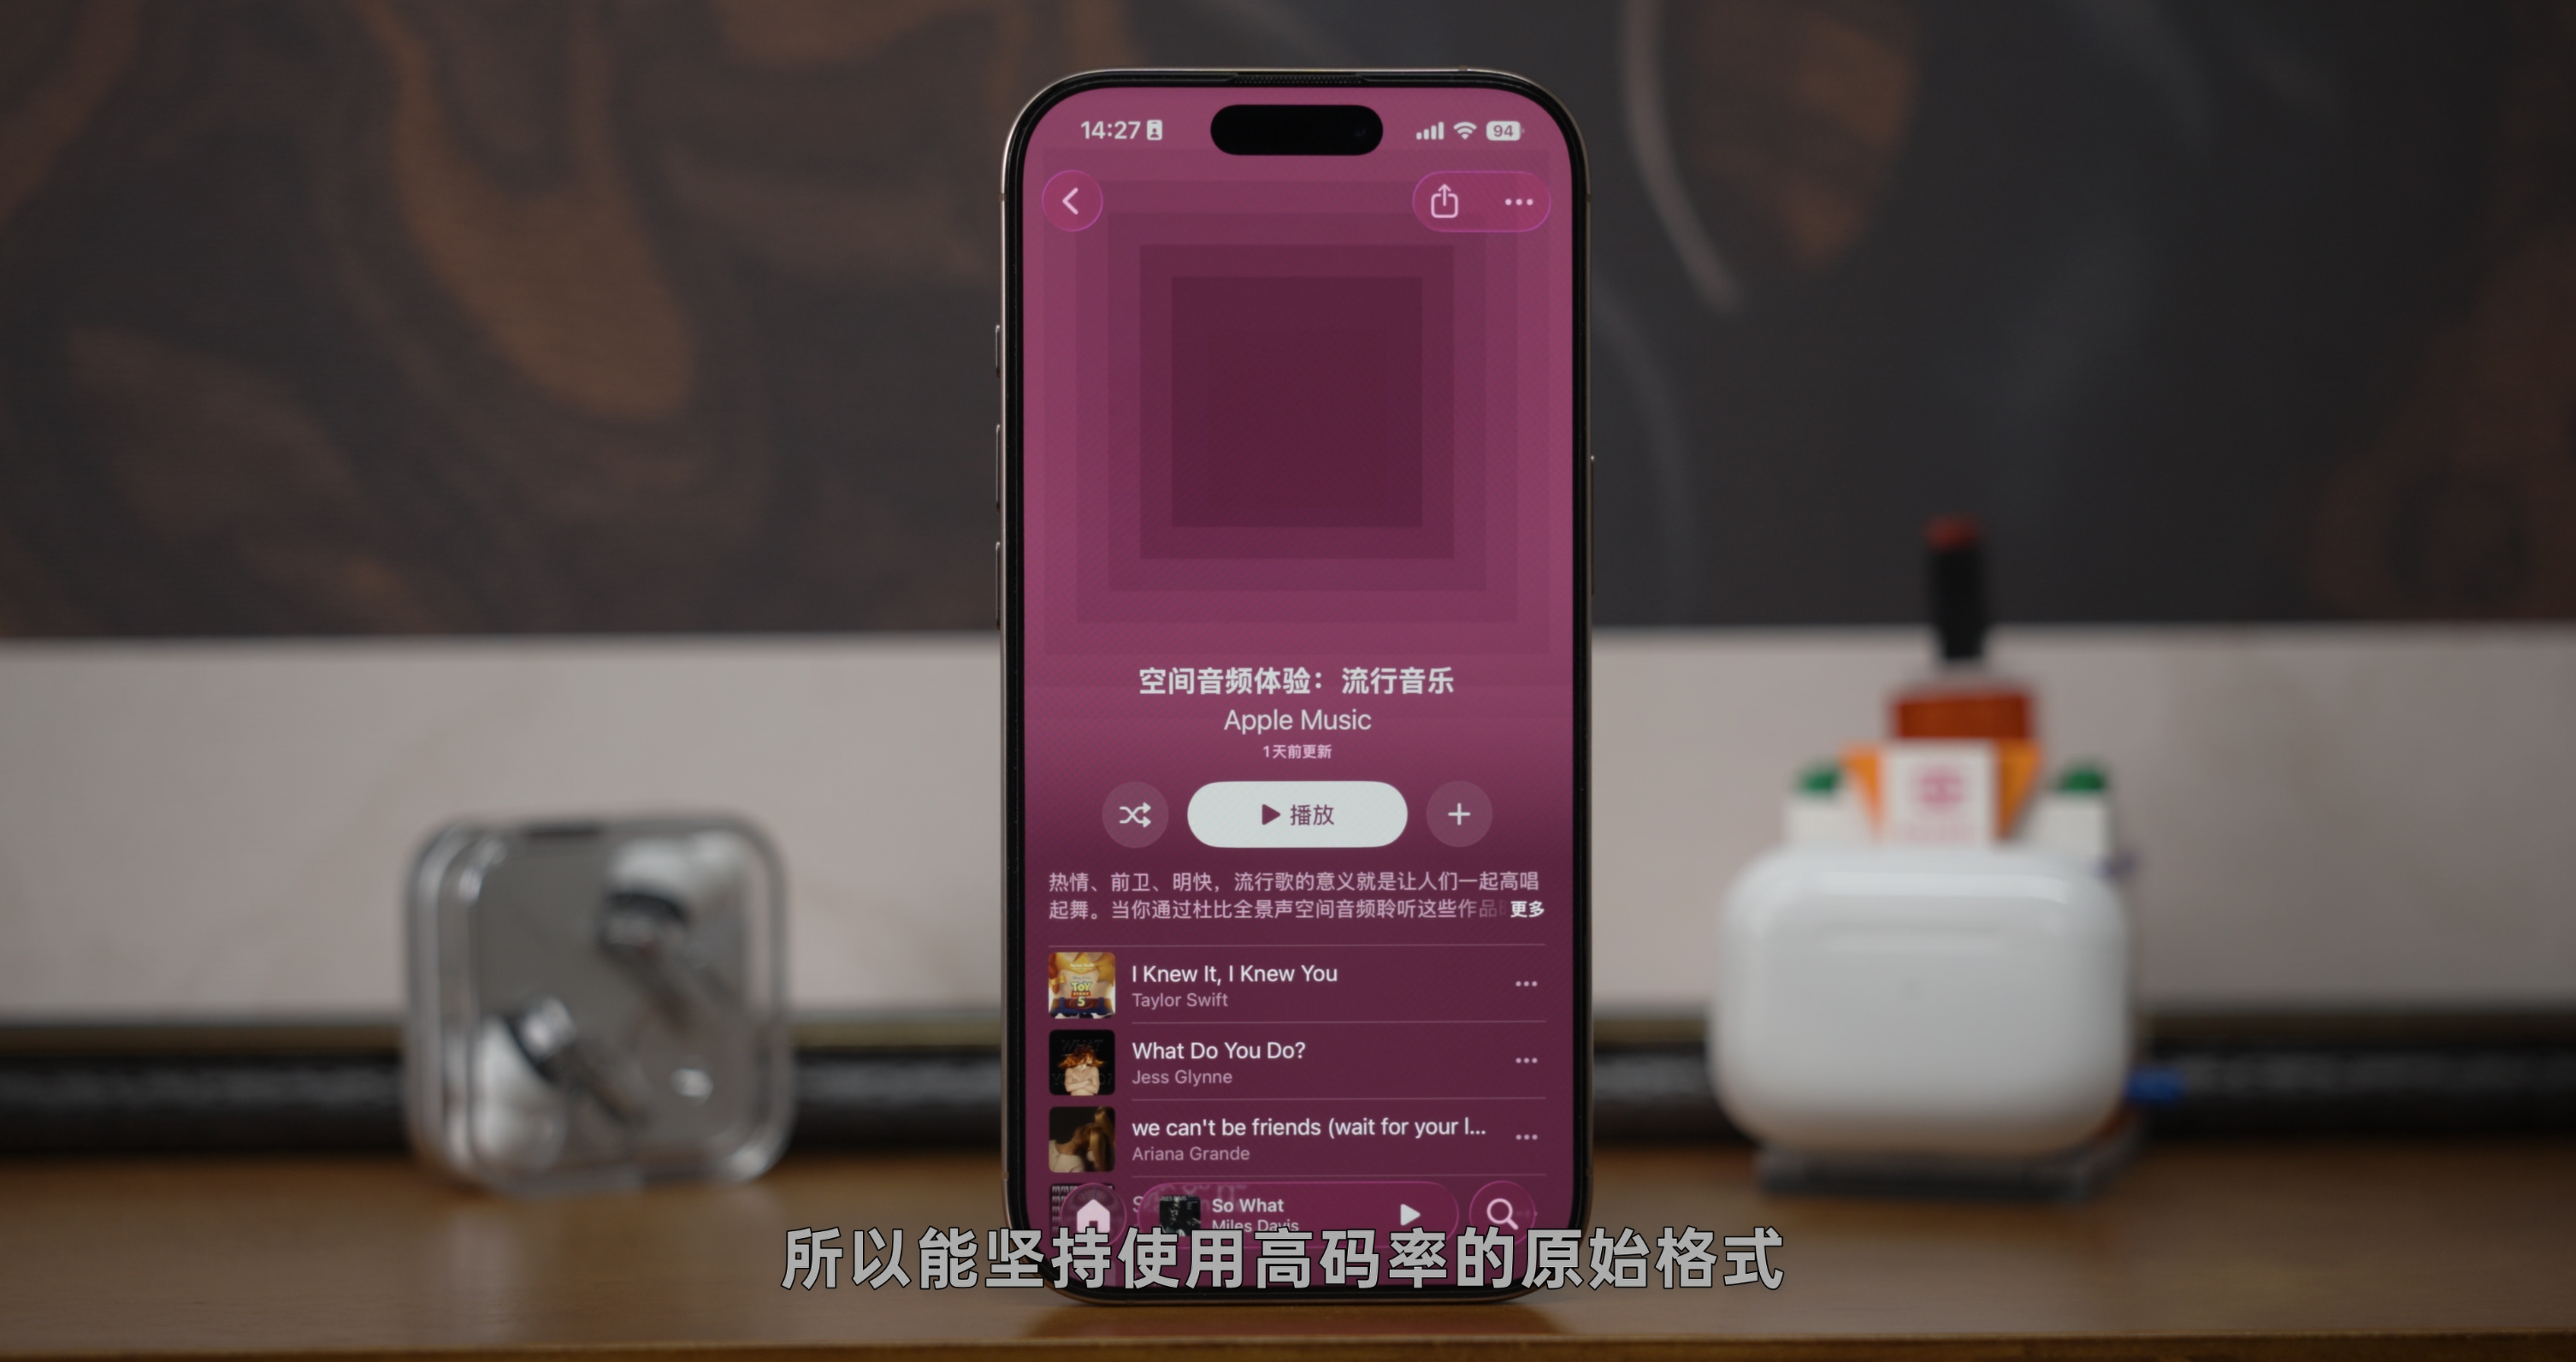
虽然大家现在都在宣传空间音频,但背后内容的编码和渲染方式有很大差异。Apple Music 的空间音频内容采用 E-AC3-JOC 编码,码率约 768 kbps。这个规格保留了足够的声道和对象信息,能在 iPhone 端完成高质量的双耳渲染和头部追踪。
而部分安卓平台的杜比全景声内容,实际使用的是 AC4-IMS 格式。
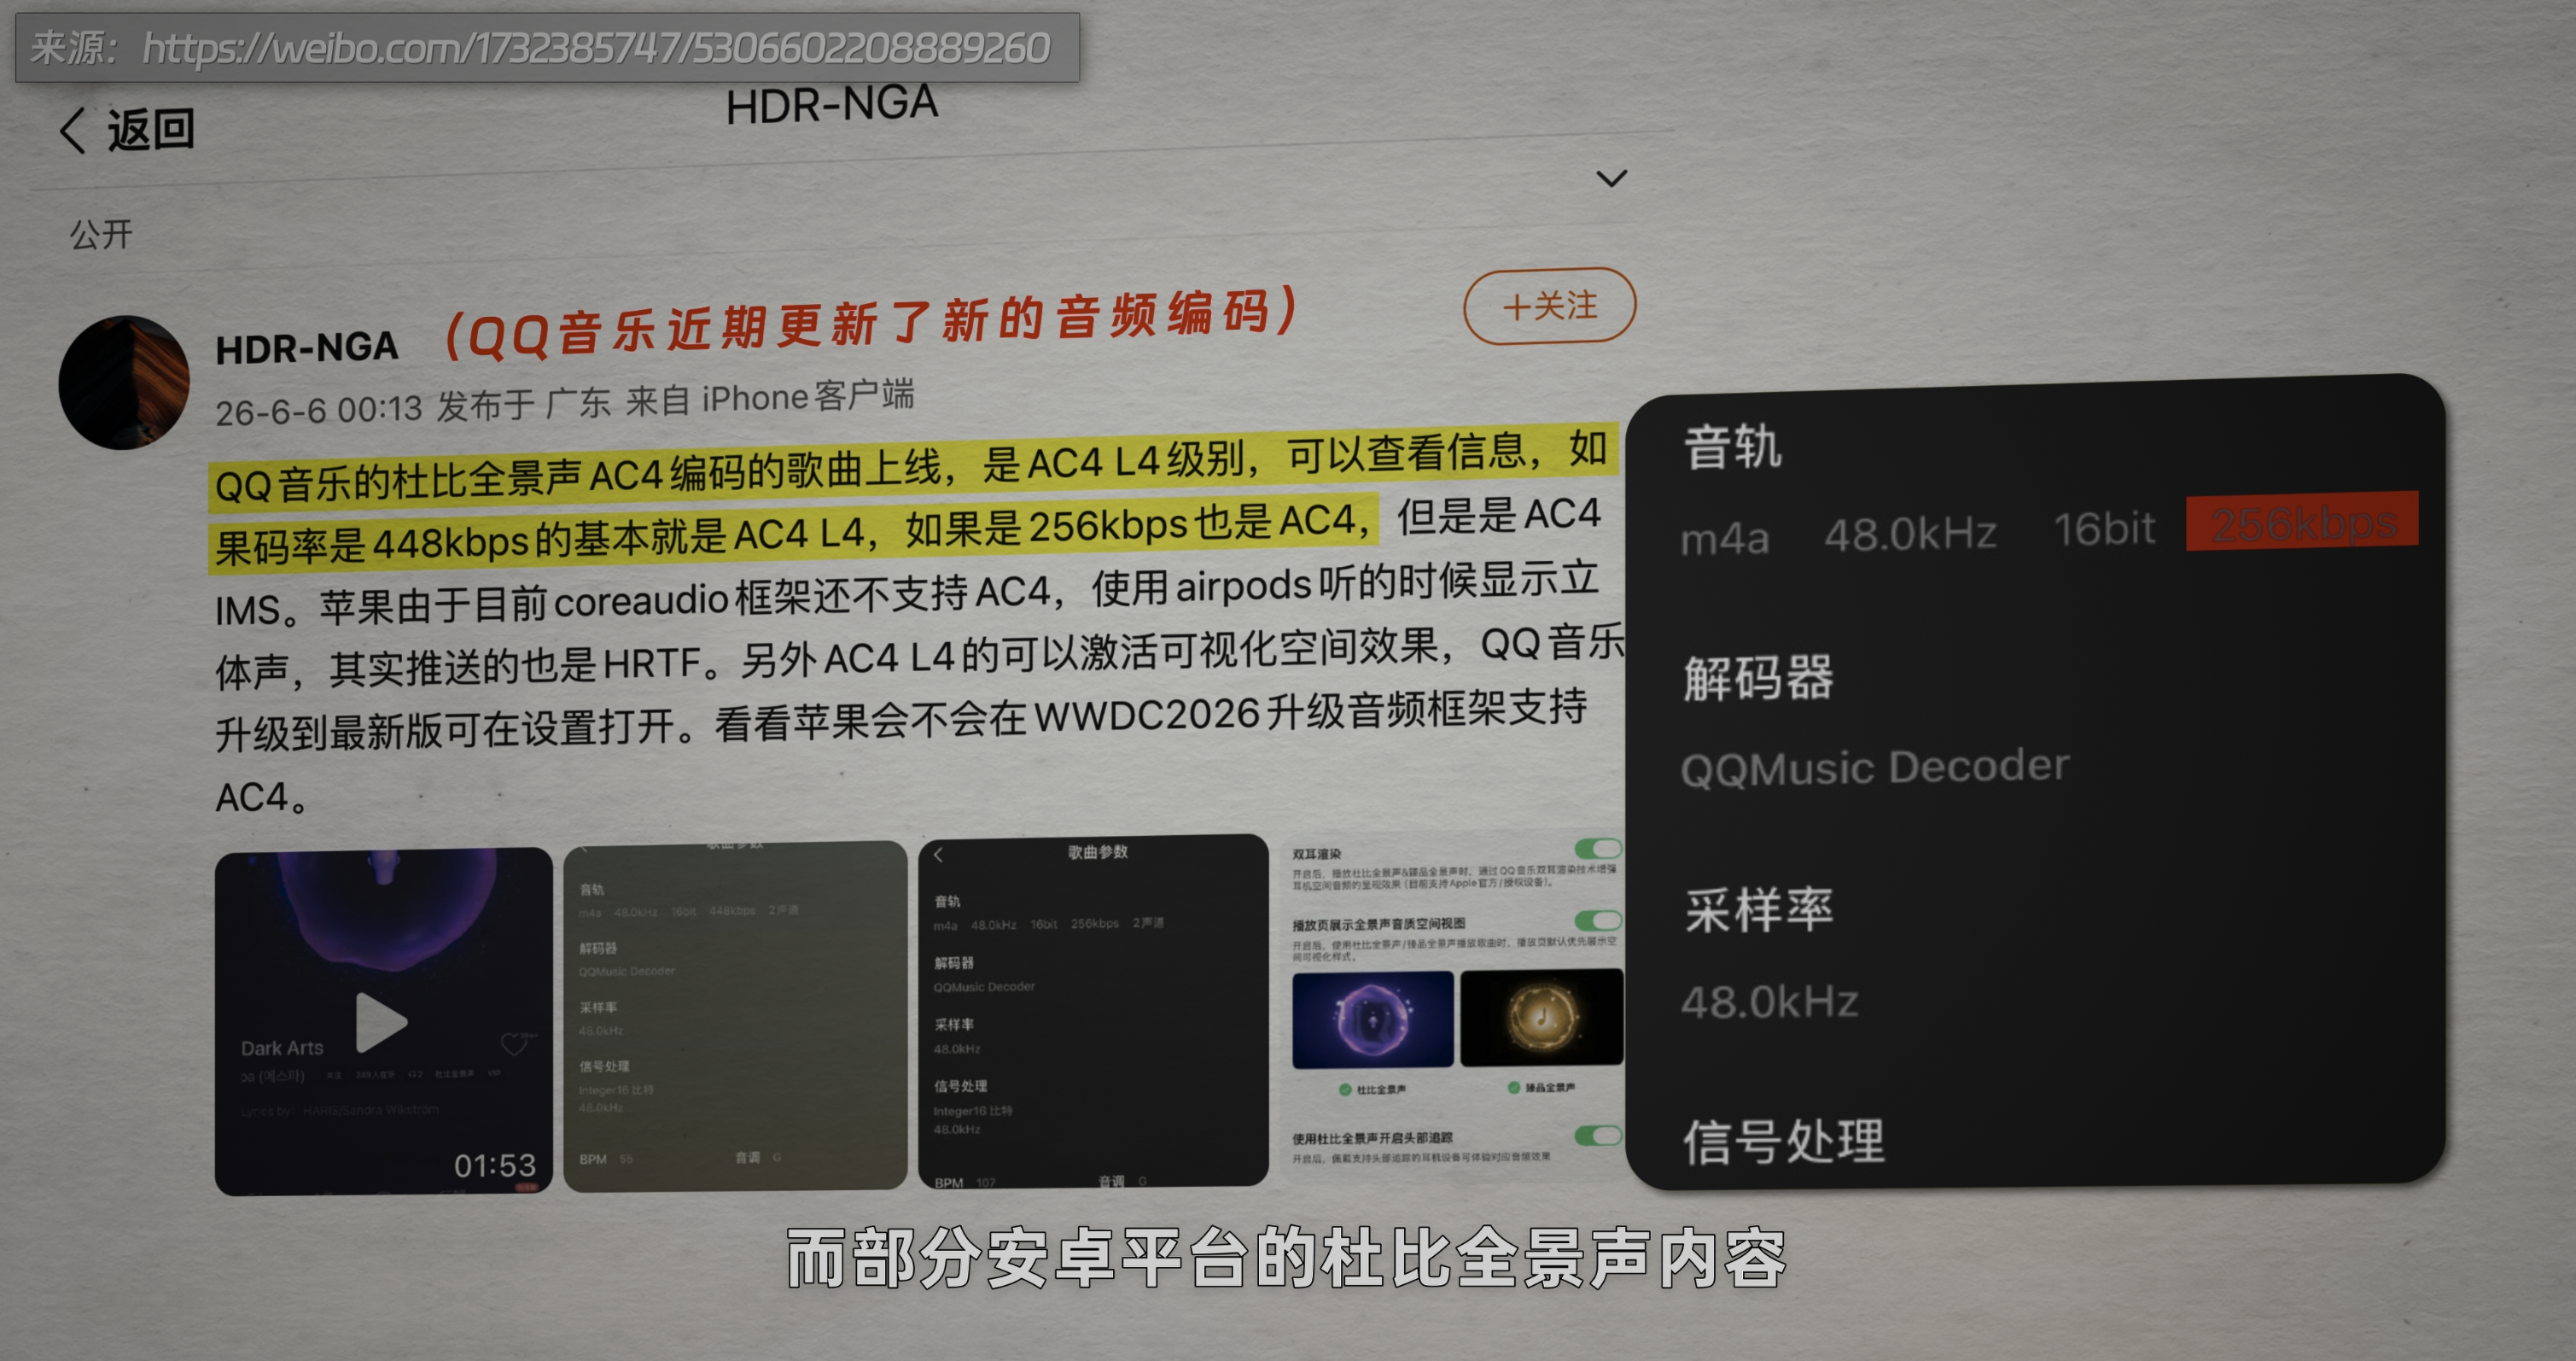
这是 AC4 编码面向移动/双耳场景的轻量方案——双声道串流,码率仅 256 kbps,两者相差 3 倍码率。更关键的是,AC4-IMS 因为预先渲染好了双耳信号,一旦引入头部追踪,系统无法在非 0 度方位正确重新计算声场。
这意味着,声称支持头部追踪的安卓设备,如果底层内容使用的是 AC4-IMS,追踪效果在算法层面就是残缺的。这种差异不是某个厂商的偷工减料,而是生态位决定的。
苹果控制了内容分发端(Apple Music)和消费端(AirPods + iOS),所以能坚持使用高码率的原始格式。安卓的内容分发端分散在 QQ 音乐、网易云等第三方平台,各平台出于带宽成本考虑,倾向于使用低码率的预制版格式。上游不在自己手里,下游也不在自己手里。
这是安卓阵营在空间音频领域的结构性困境。
06
从兼容杜比到定义标准
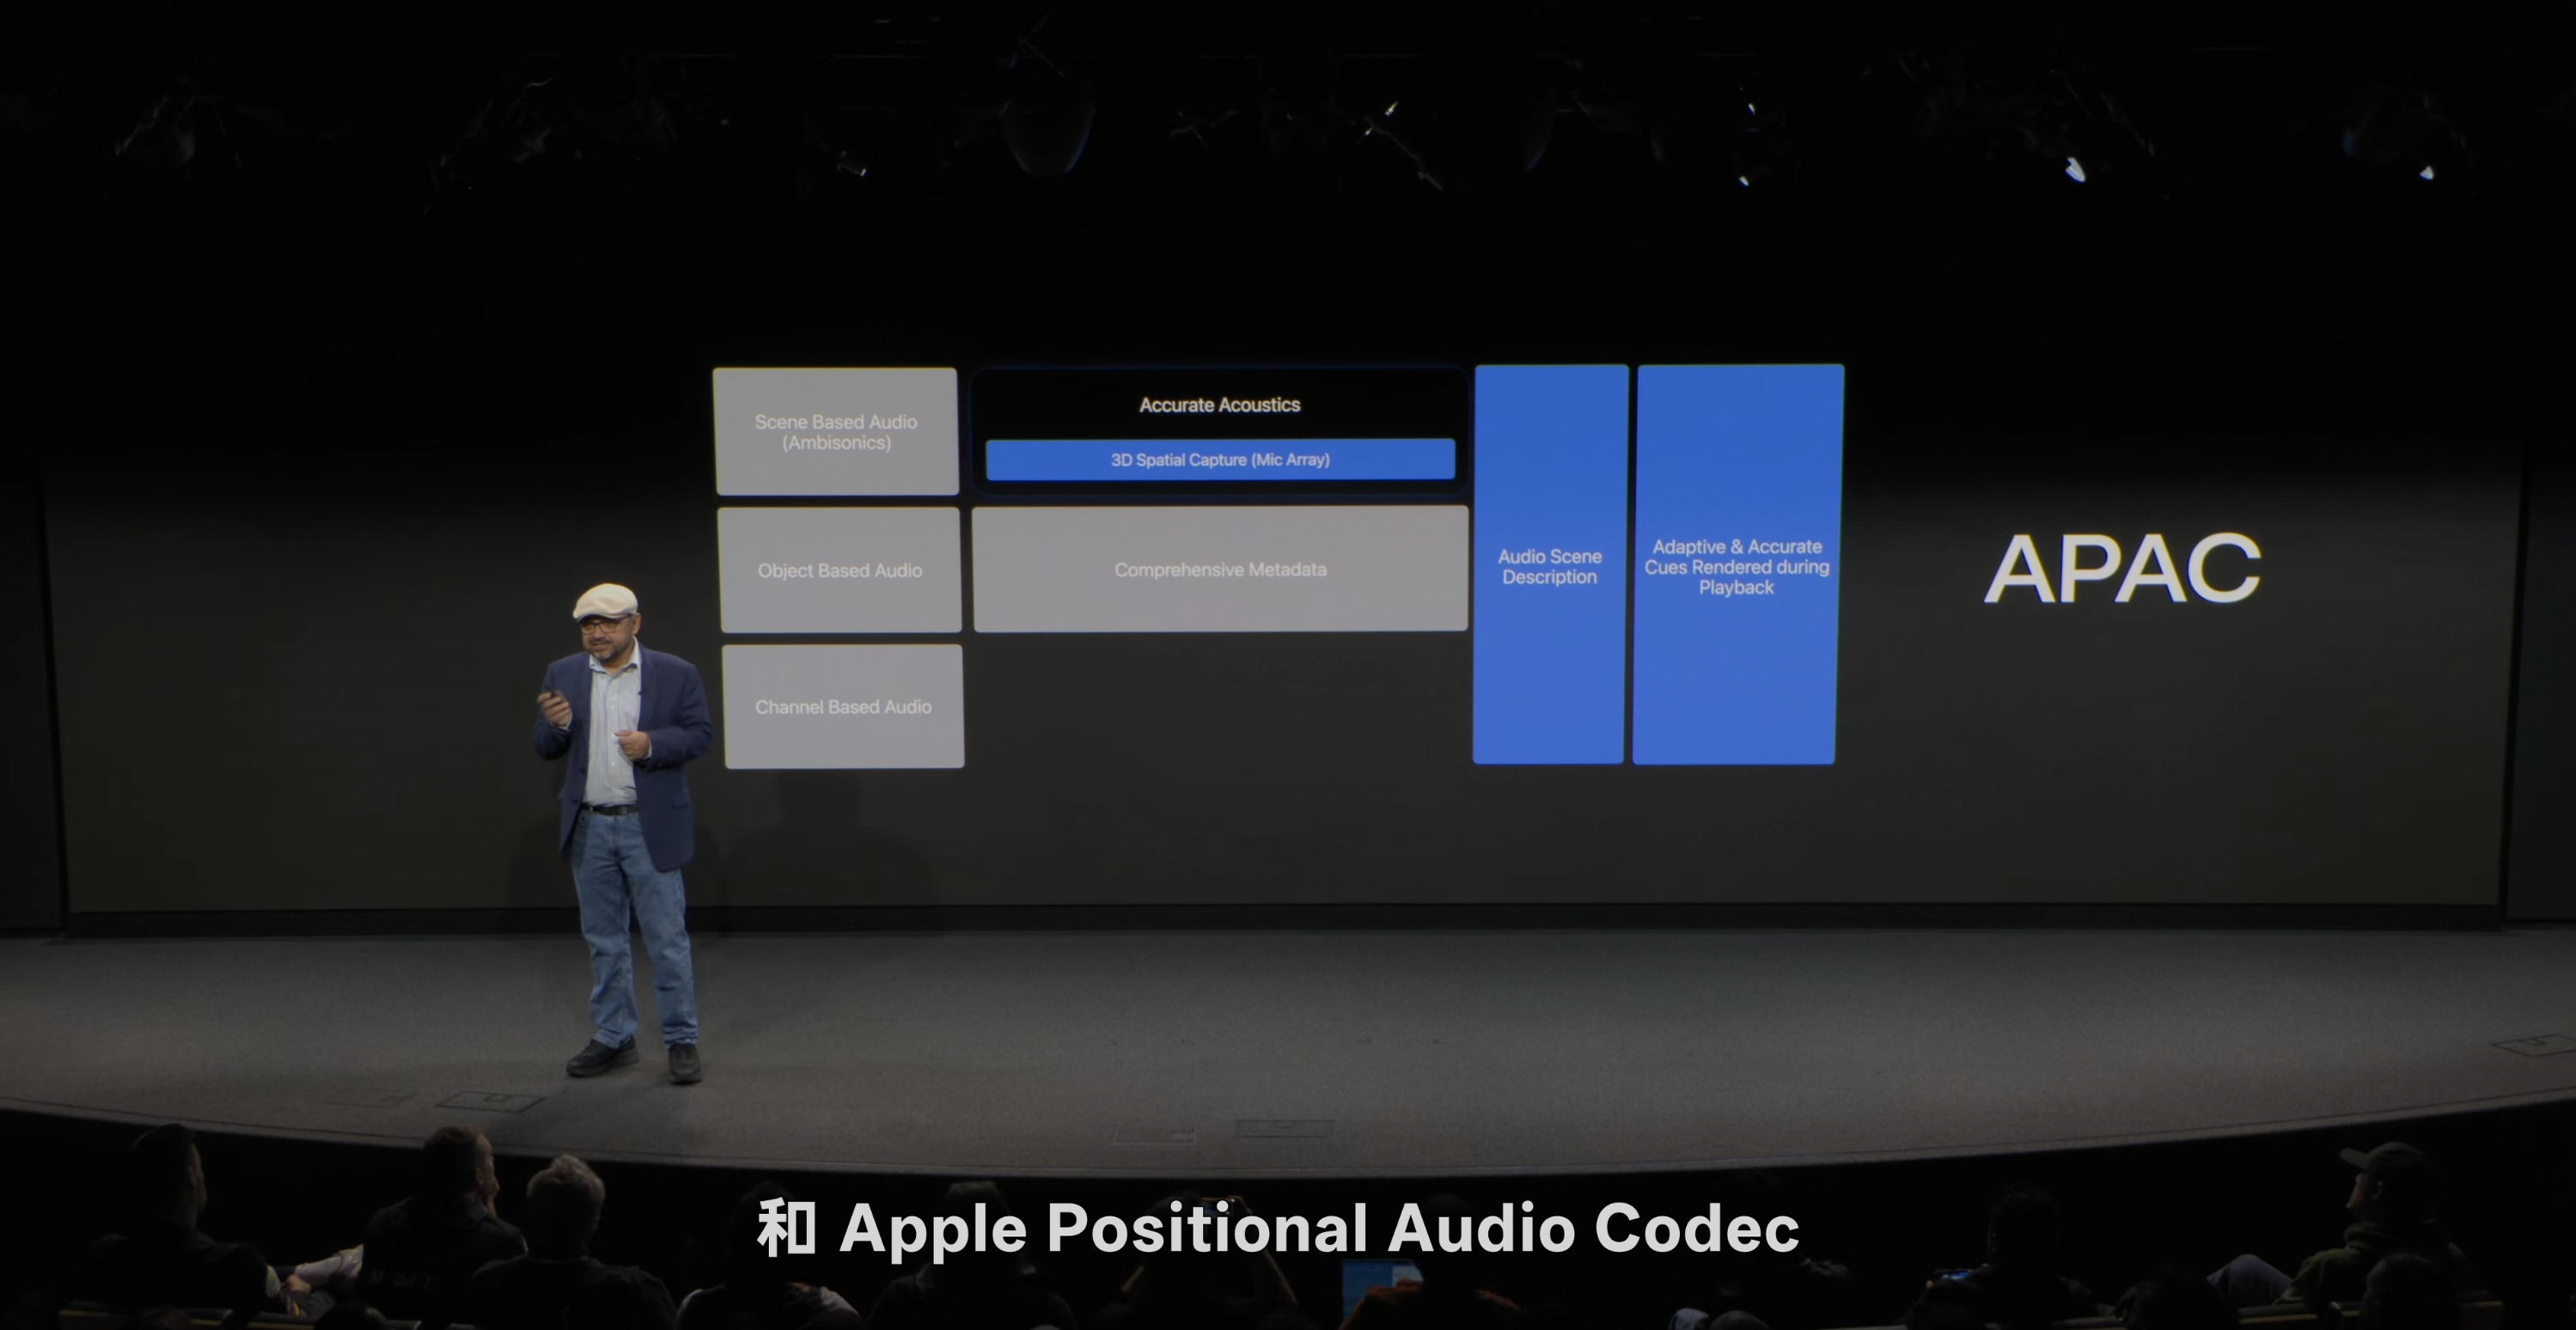
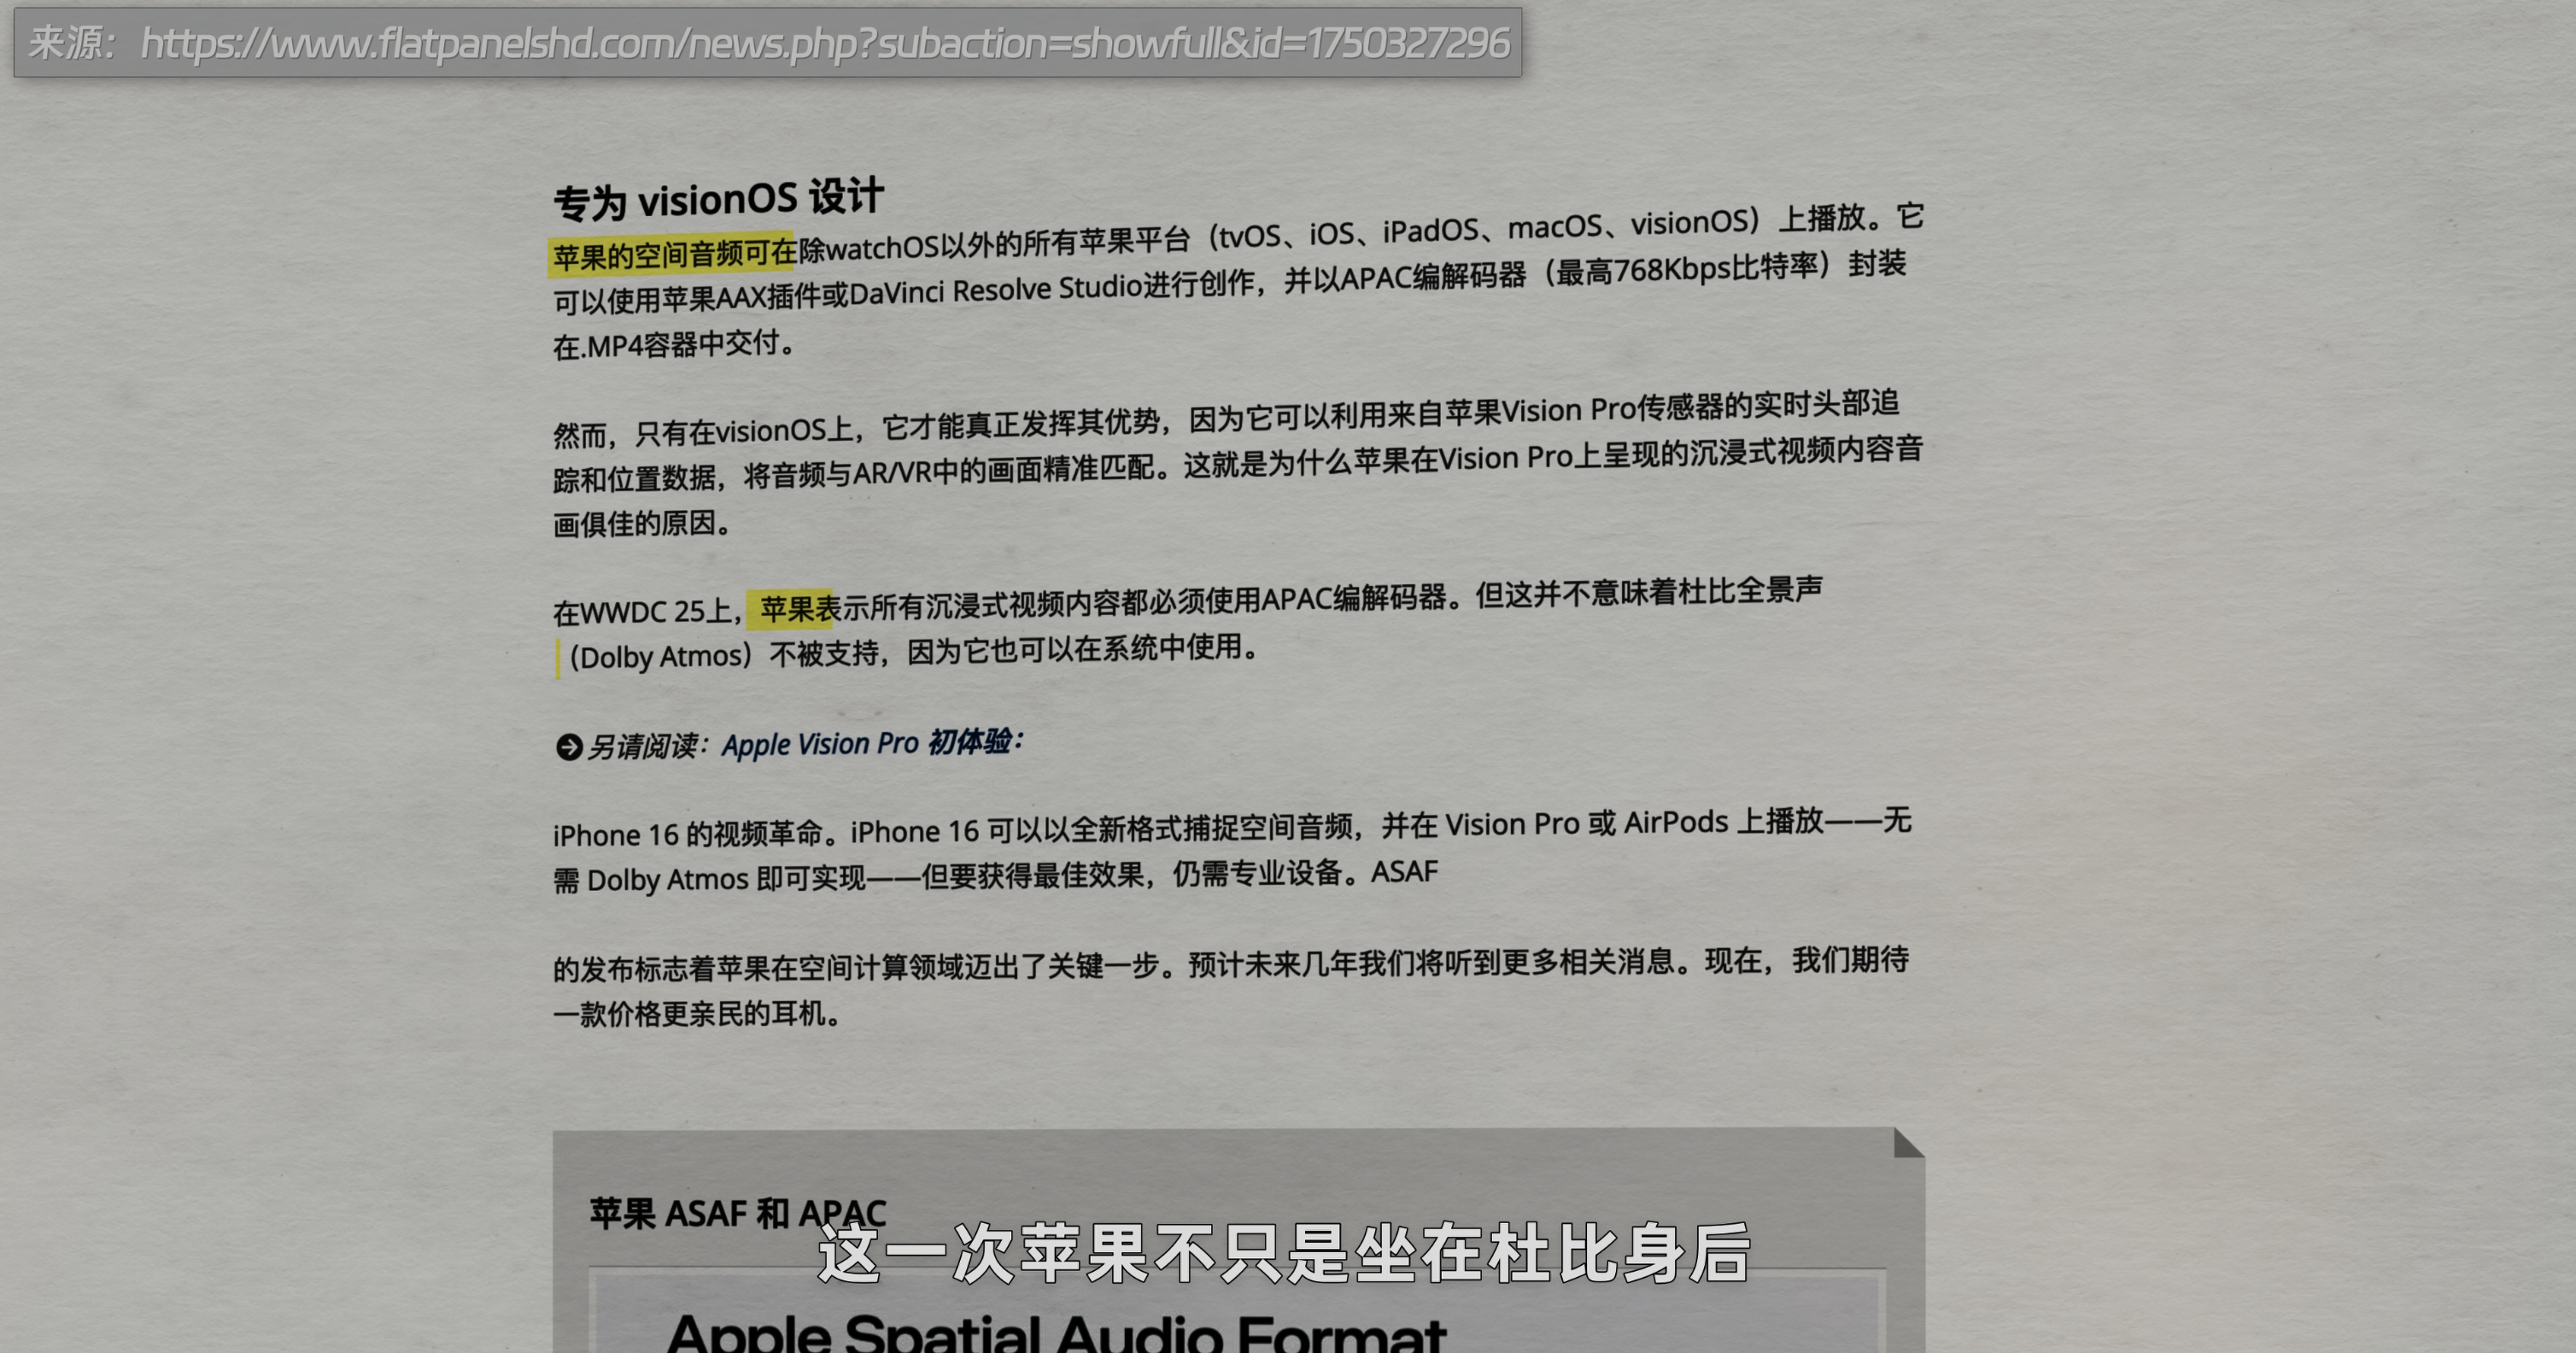
然而事情远没结束,2025 年的 WWDC,苹果做了一个此前从未有过的动作。它推出了自己的沉浸式音频格式标准:ASAF(Apple Spatial Audio Format)和 APAC(Apple Positional Audio Codec)。
ASAF 是制作端格式,APAC 是分发端编解码。
这意味着什么,意味着苹果从兼容杜比全景声转向建立自己的格式标准。
从借力标准转向定义标准,这是一个战略级别的转变。
此前,苹果支持杜比全景声内容,但在渲染端使用自研算法。
现在,它连内容格式都想自己定。其中 ASAF 支持的这个五阶高阶环绕声场尤其值得注意。这个级别的空间精度,对应 36 个虚拟声道,远超耳机消费端的需求。AirPods 听首歌,根本不需要这么高的精度。
这是为 Vision Pro 和后续空间计算设备储备的。今天的耳机音乐,明天的空间计算。ASAF 可以让同一套内容格式在不同设备当中无缝迁移。
这一次苹果不只是坐在杜比身后,而是把自己的牌推上了桌面。
07
冰山之下
在写这篇稿子的过程中,其实我内心一直有一个问题没有被解答,视频前半部分的叙事逻辑,是站在一个重要的假设上,苹果空间音频的起步,是从收购 Beats 团队开始的,但事实真的是这样吗。
这个前提建设,是否真的足够稳固,到底是 Beats 有过人之处,还是收购案只是一个标志性的事件,我其实在一开始没有找到更多的支撑。直到我通过检索苹果空间音频相关的专利,再交叉检索专利发明人履历的方式,确认了 AirPods Pro 上的空间音频,他根本就不是一个五年前伏笔,而是一个可能横跨超过十年的布局。
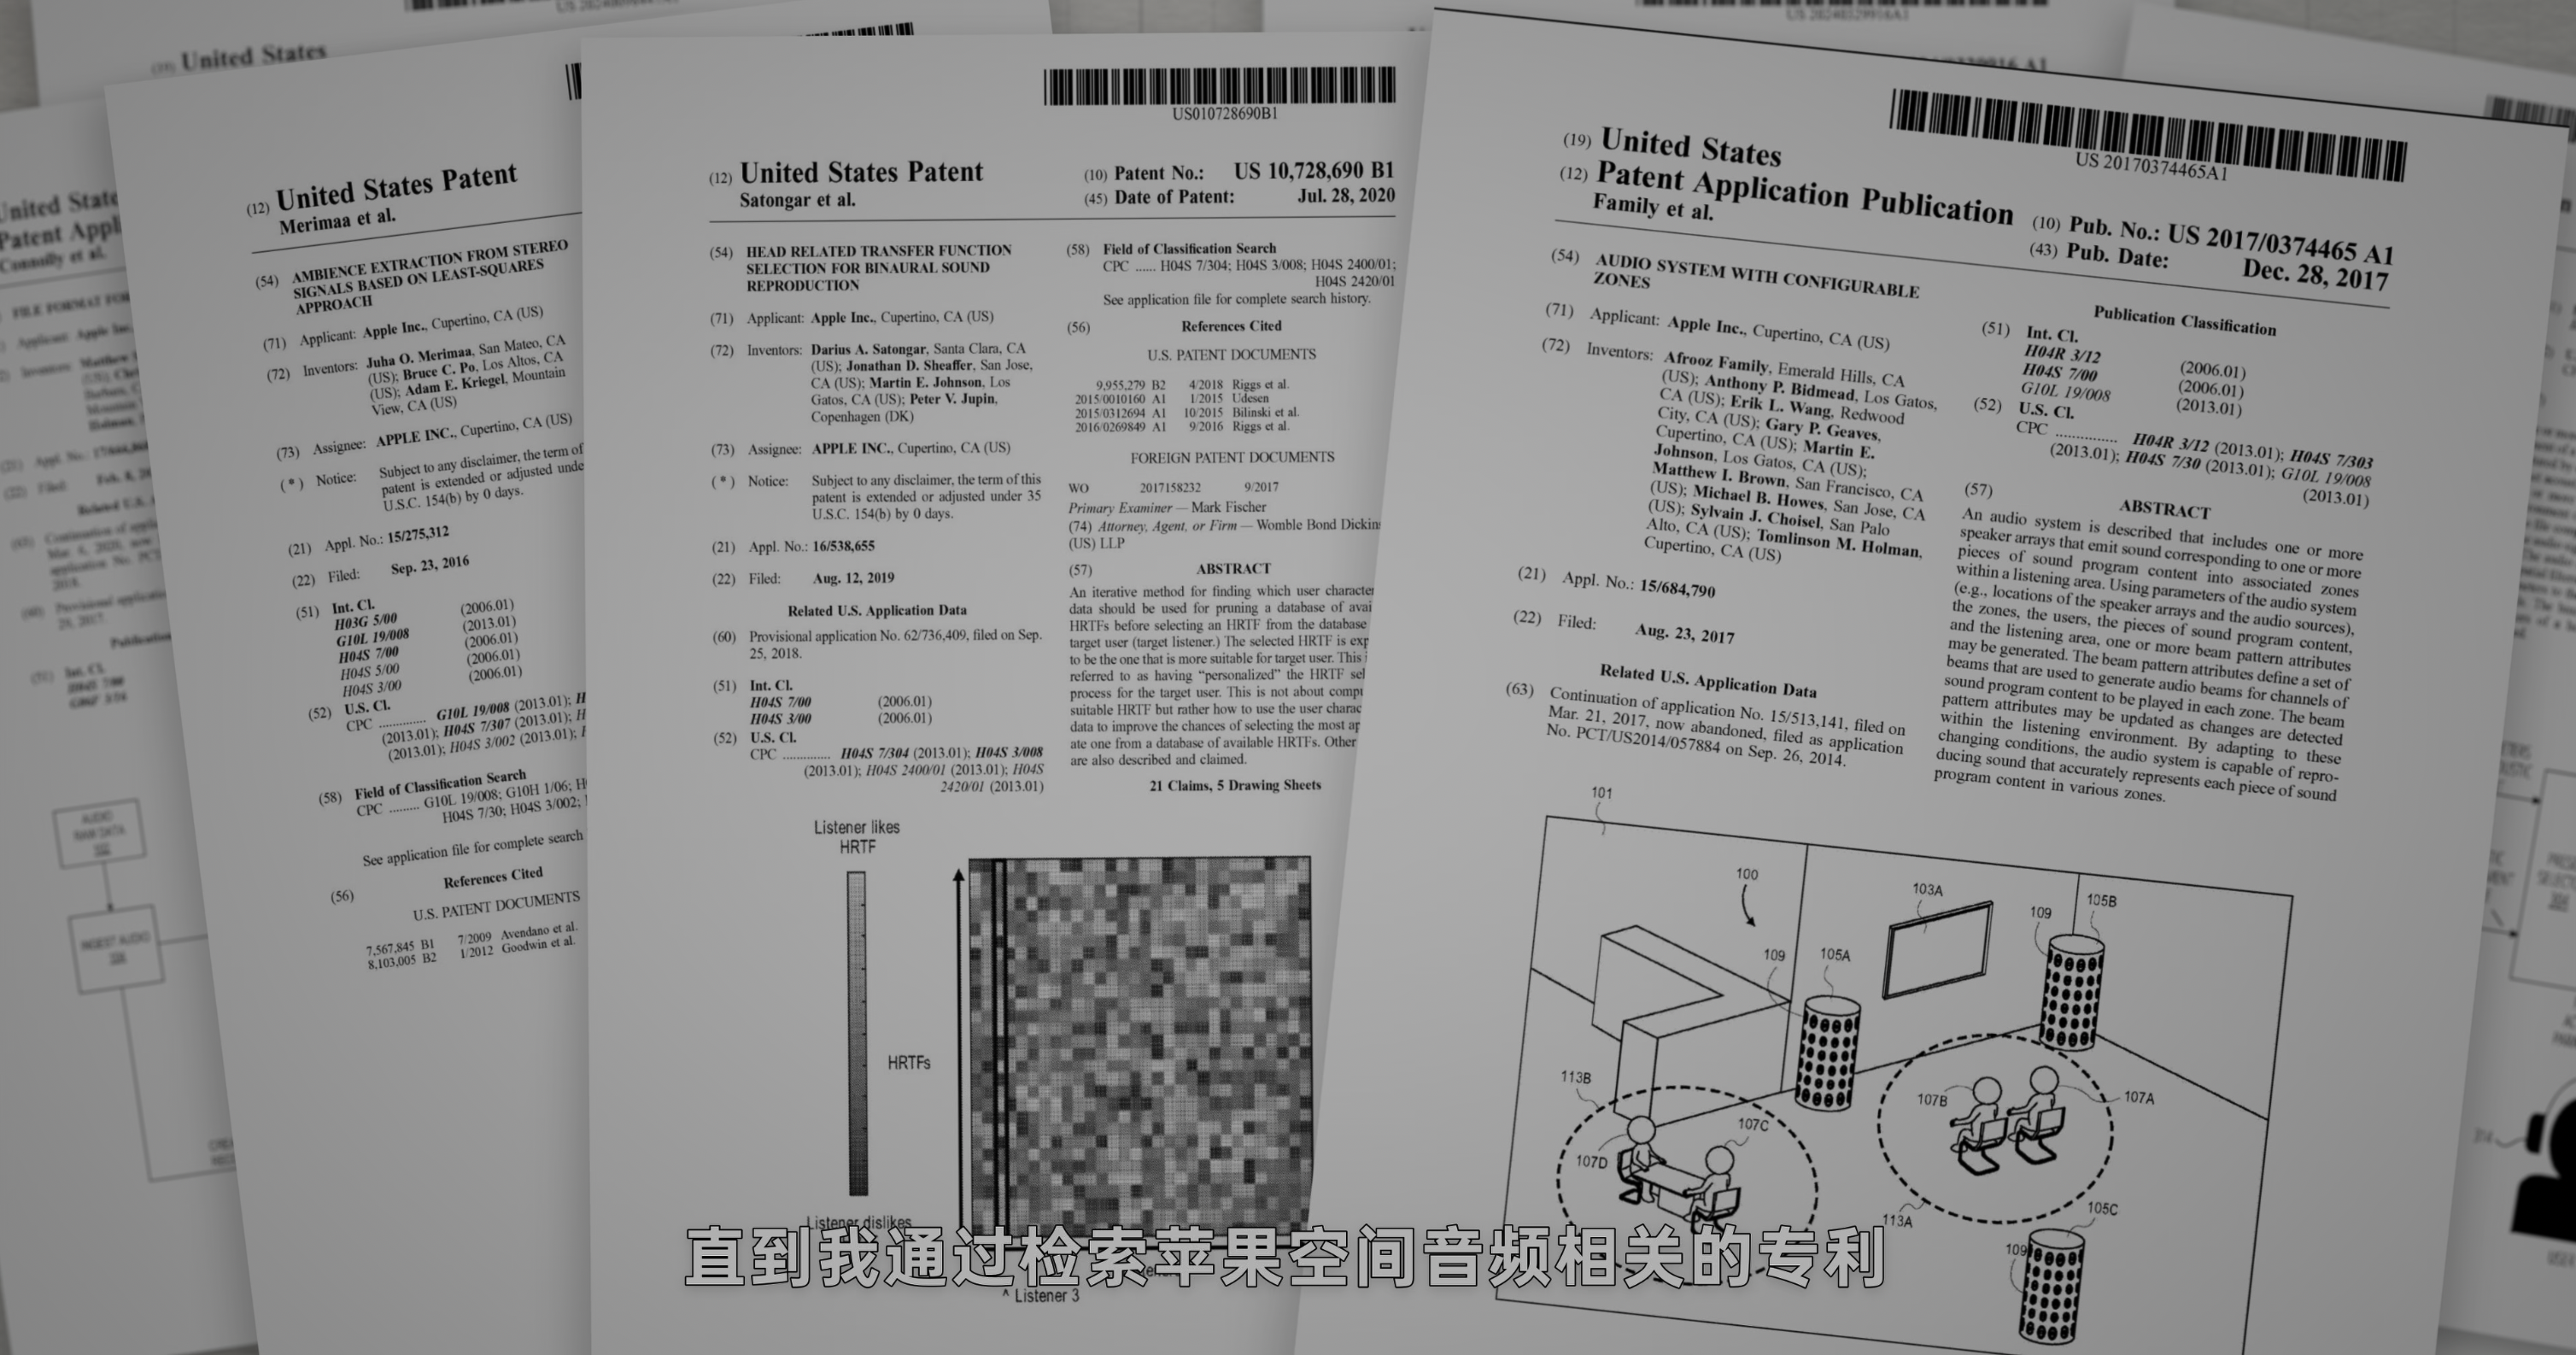
我这边找到最早的一篇专利,是有关双耳渲染的,主要发明人尤哈 Juha Merimaa 于 2012 年加入苹果,在之前他是森海塞尔的算法工程师。
HRTF 建模这篇专利,发明人戴瑞斯 Darius Satongar 在 2011 年加入苹果之前,曾经在杜比短暂待过。
这篇空间音频编码专利,Erik Wang 作为产品设计师于2000 年加入苹果,在职已经超过了 25 年。
Gary Geaves 2011 年从宝华韦健加入苹果,离开苹果之前他是整个声学团队的负责人。
而 Tomlinson Holman (汤姆林森,霍尔曼)这位更是重量级,他是卢卡斯影业 THX 音响系统的发明人,2002 年就获得了奥斯卡的技术成就奖,堪称空间音频领域的活化石,据报道他在 2011 年的时候加入苹果,一呆就呆了十年。
而且一些有意思的现象是,近几年有关空间音频的专利,做运动识别的、交互设计的、XR 系统的,这些在声学之外的专家,也开始出现在专利发明人中间。
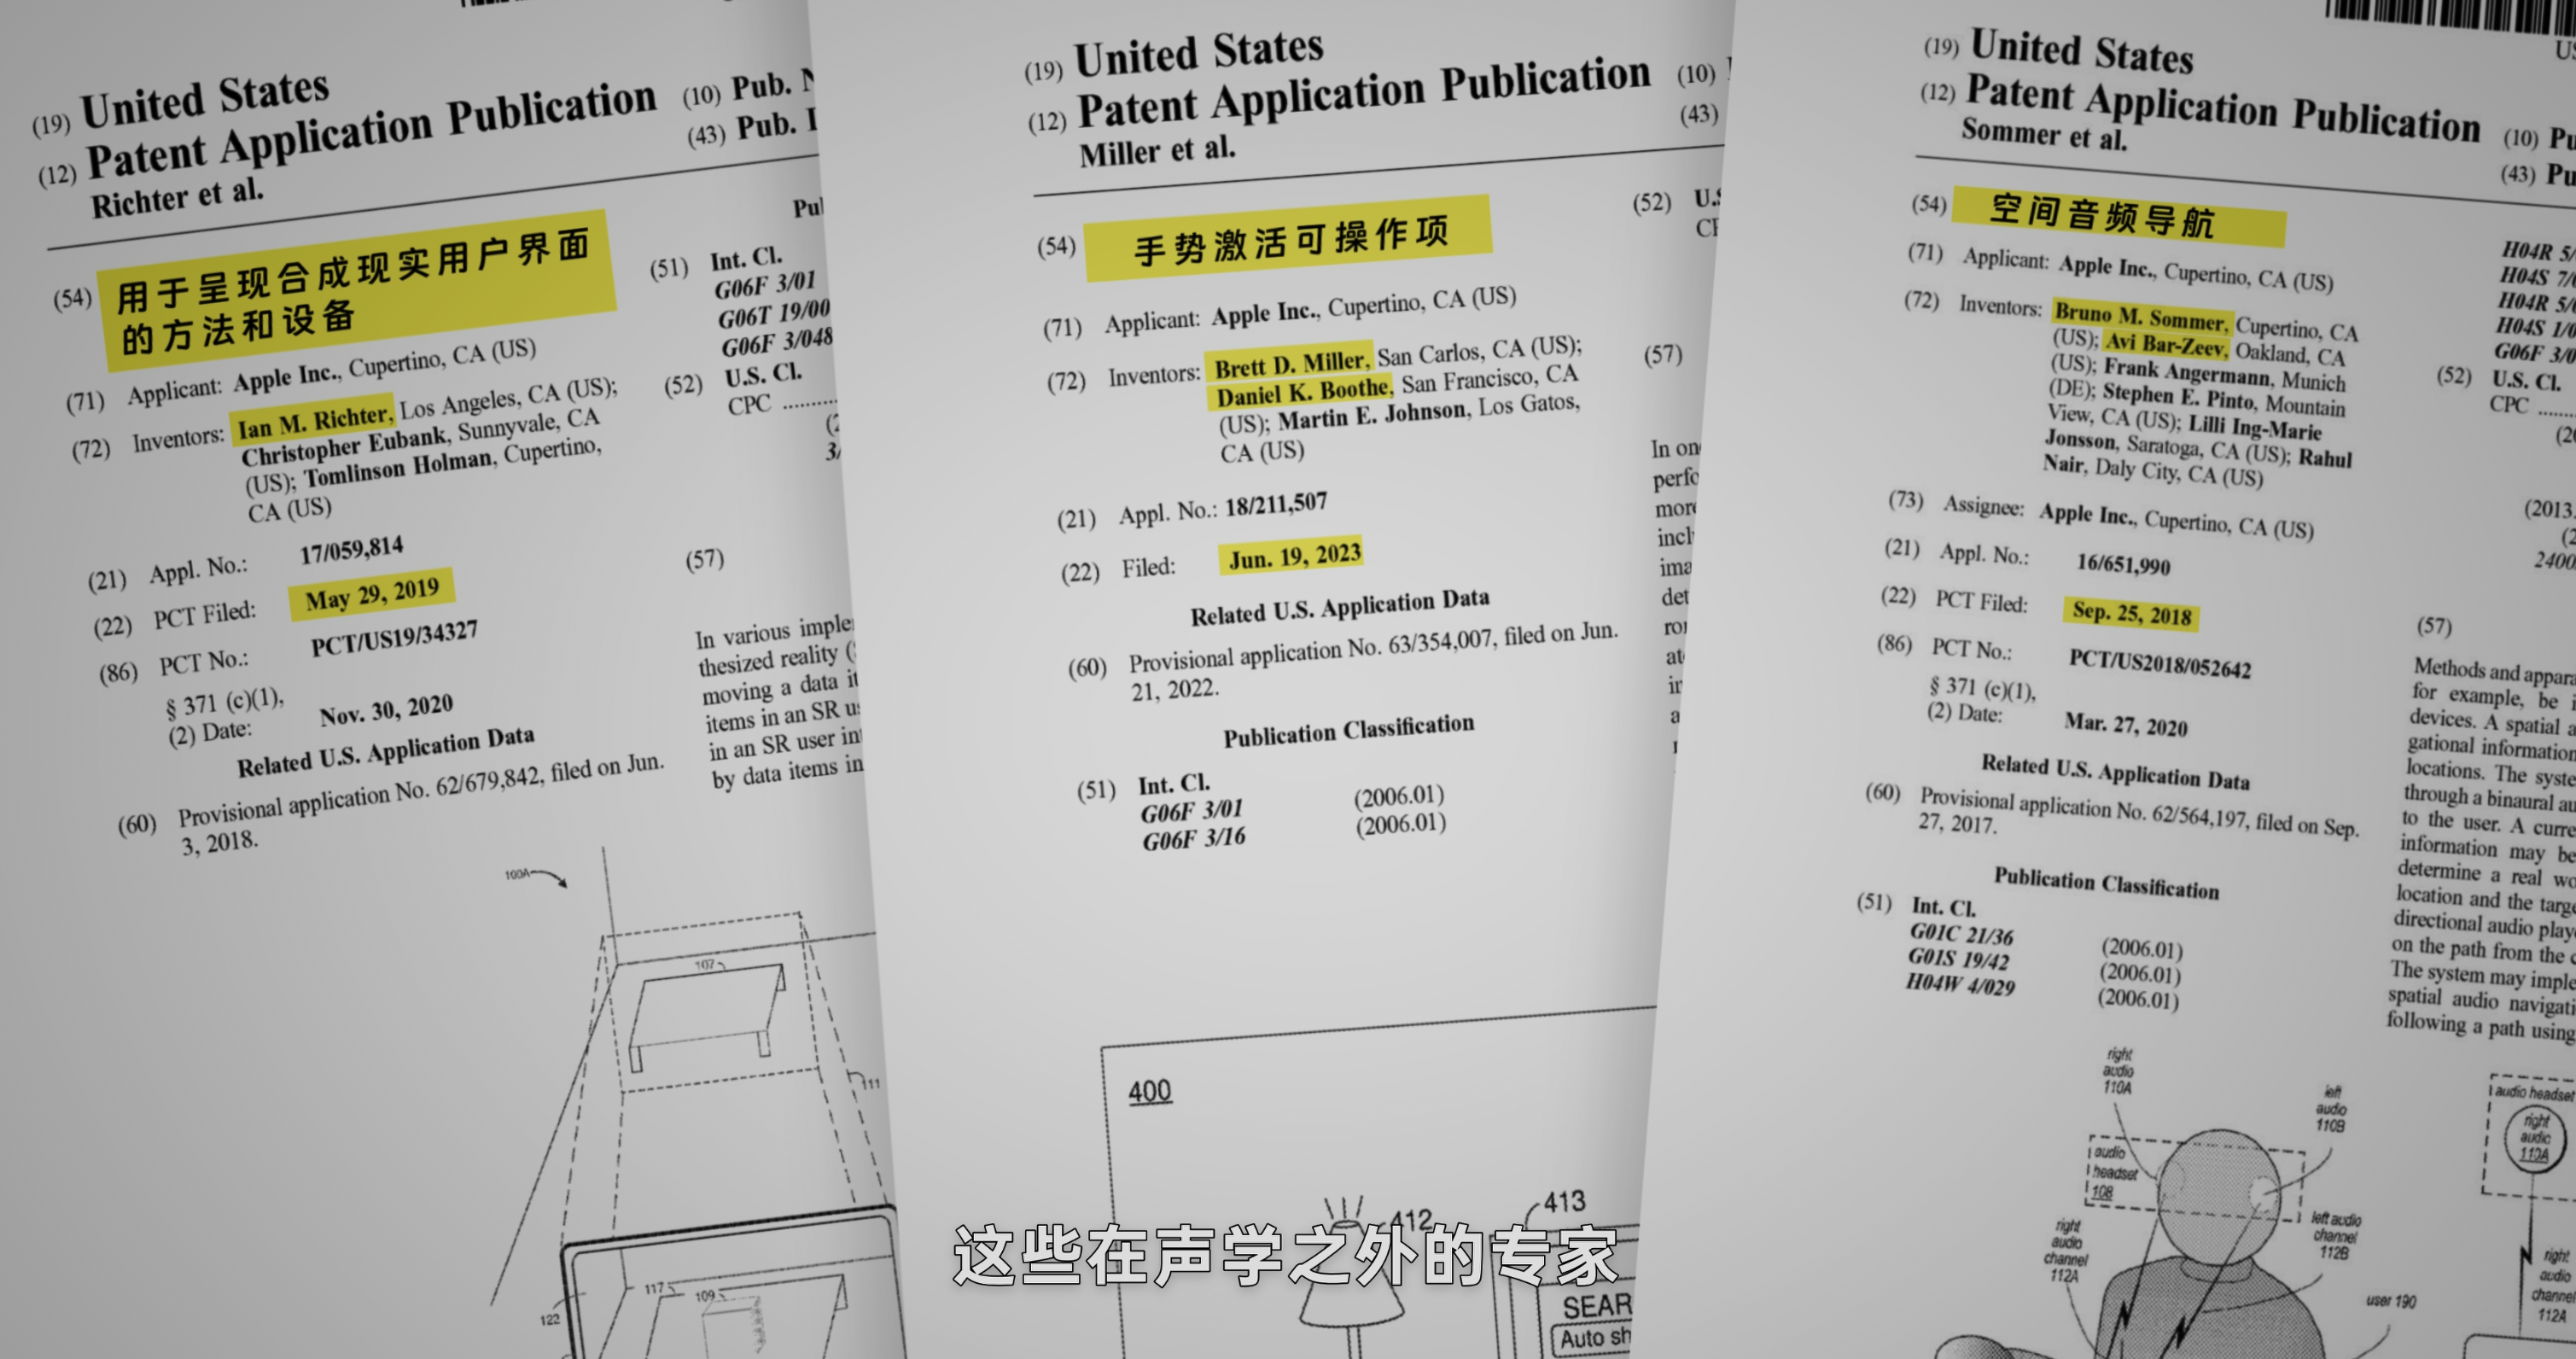
这让 Beats 的位置变得有些微妙。
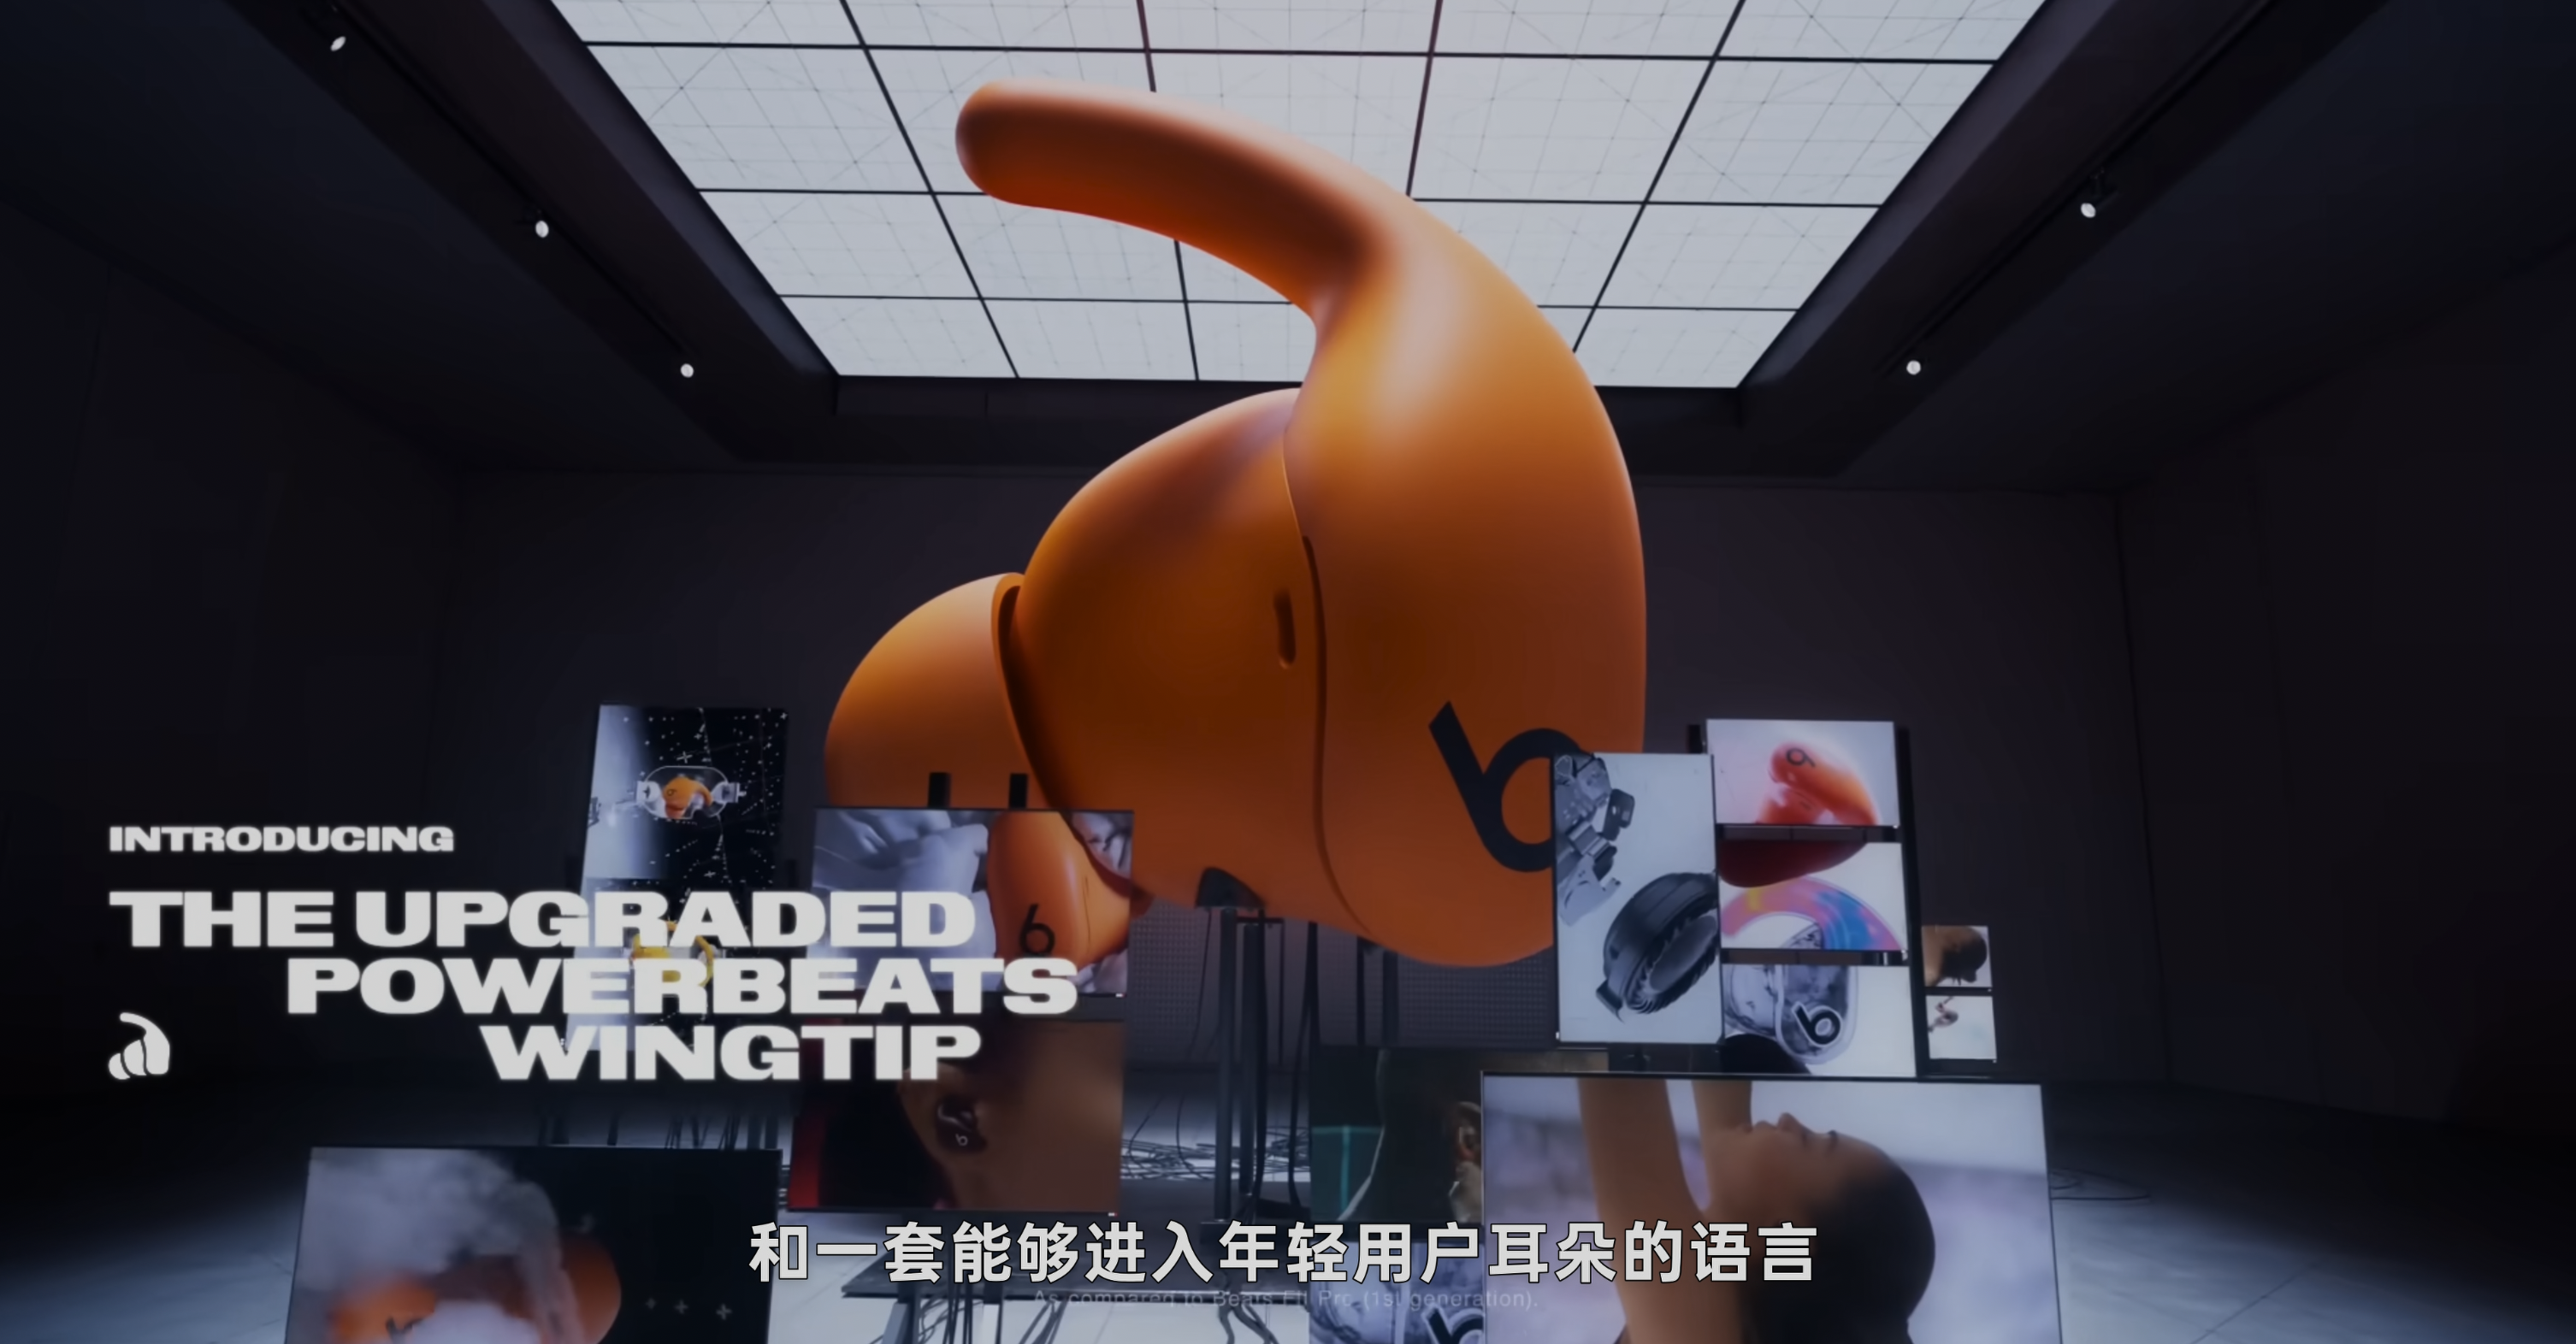
它当然重要,2014 年,苹果用 30 亿美元买下的不只是一个耳机品牌,还有音乐服务、消费音频经验和一套进入年轻用户耳朵的语言;但如果把空间音频的起点放在 Beats,故事反而被讲窄了。
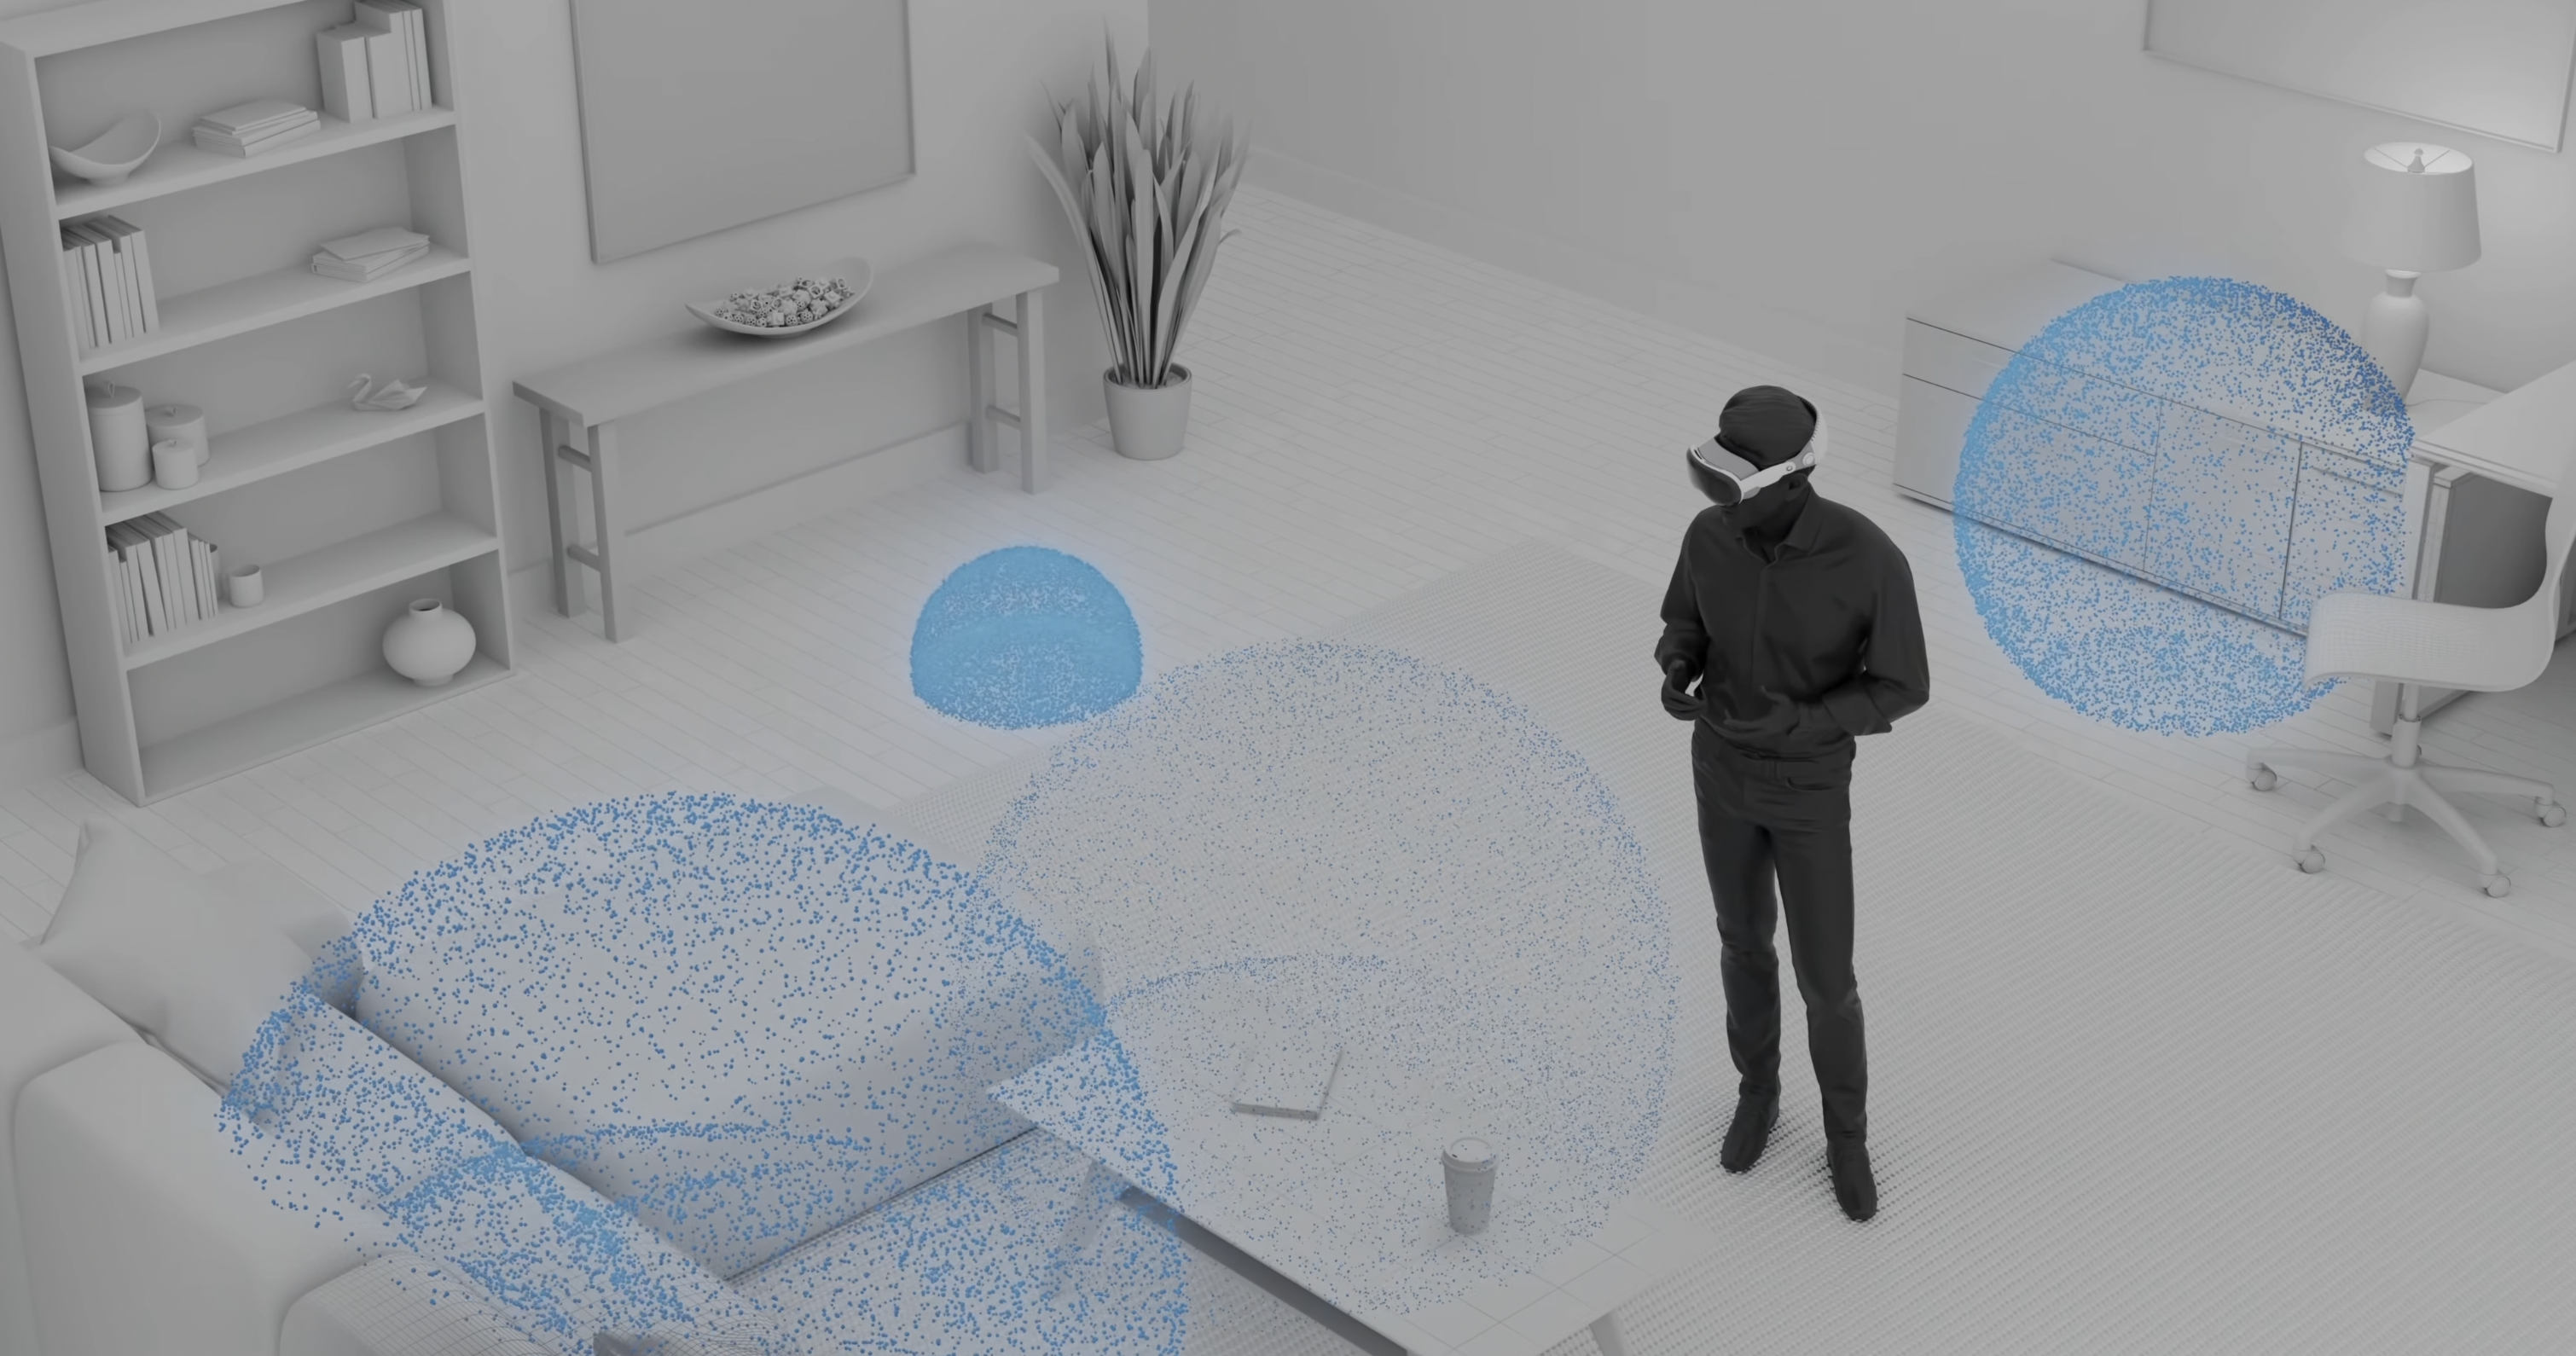
专利发明人的履历把时间线继续往前推。2011 年前后,苹果已经开始把一批很不一样的人放进同一个系统里:做影院声学工程的,做高端音响的,做双耳渲染的,做传感器融合的,做交互设计的。
他们的工作一开始并不都指向 AirPods。有人服务于 Siri 和语音入口,有人服务于客厅和 HomePod,有人服务于 ARKit,有人服务于后来的 Vision Pro。空间音频只是他们在十年后相遇的地方。这也是苹果护城河真正难讲的部分。
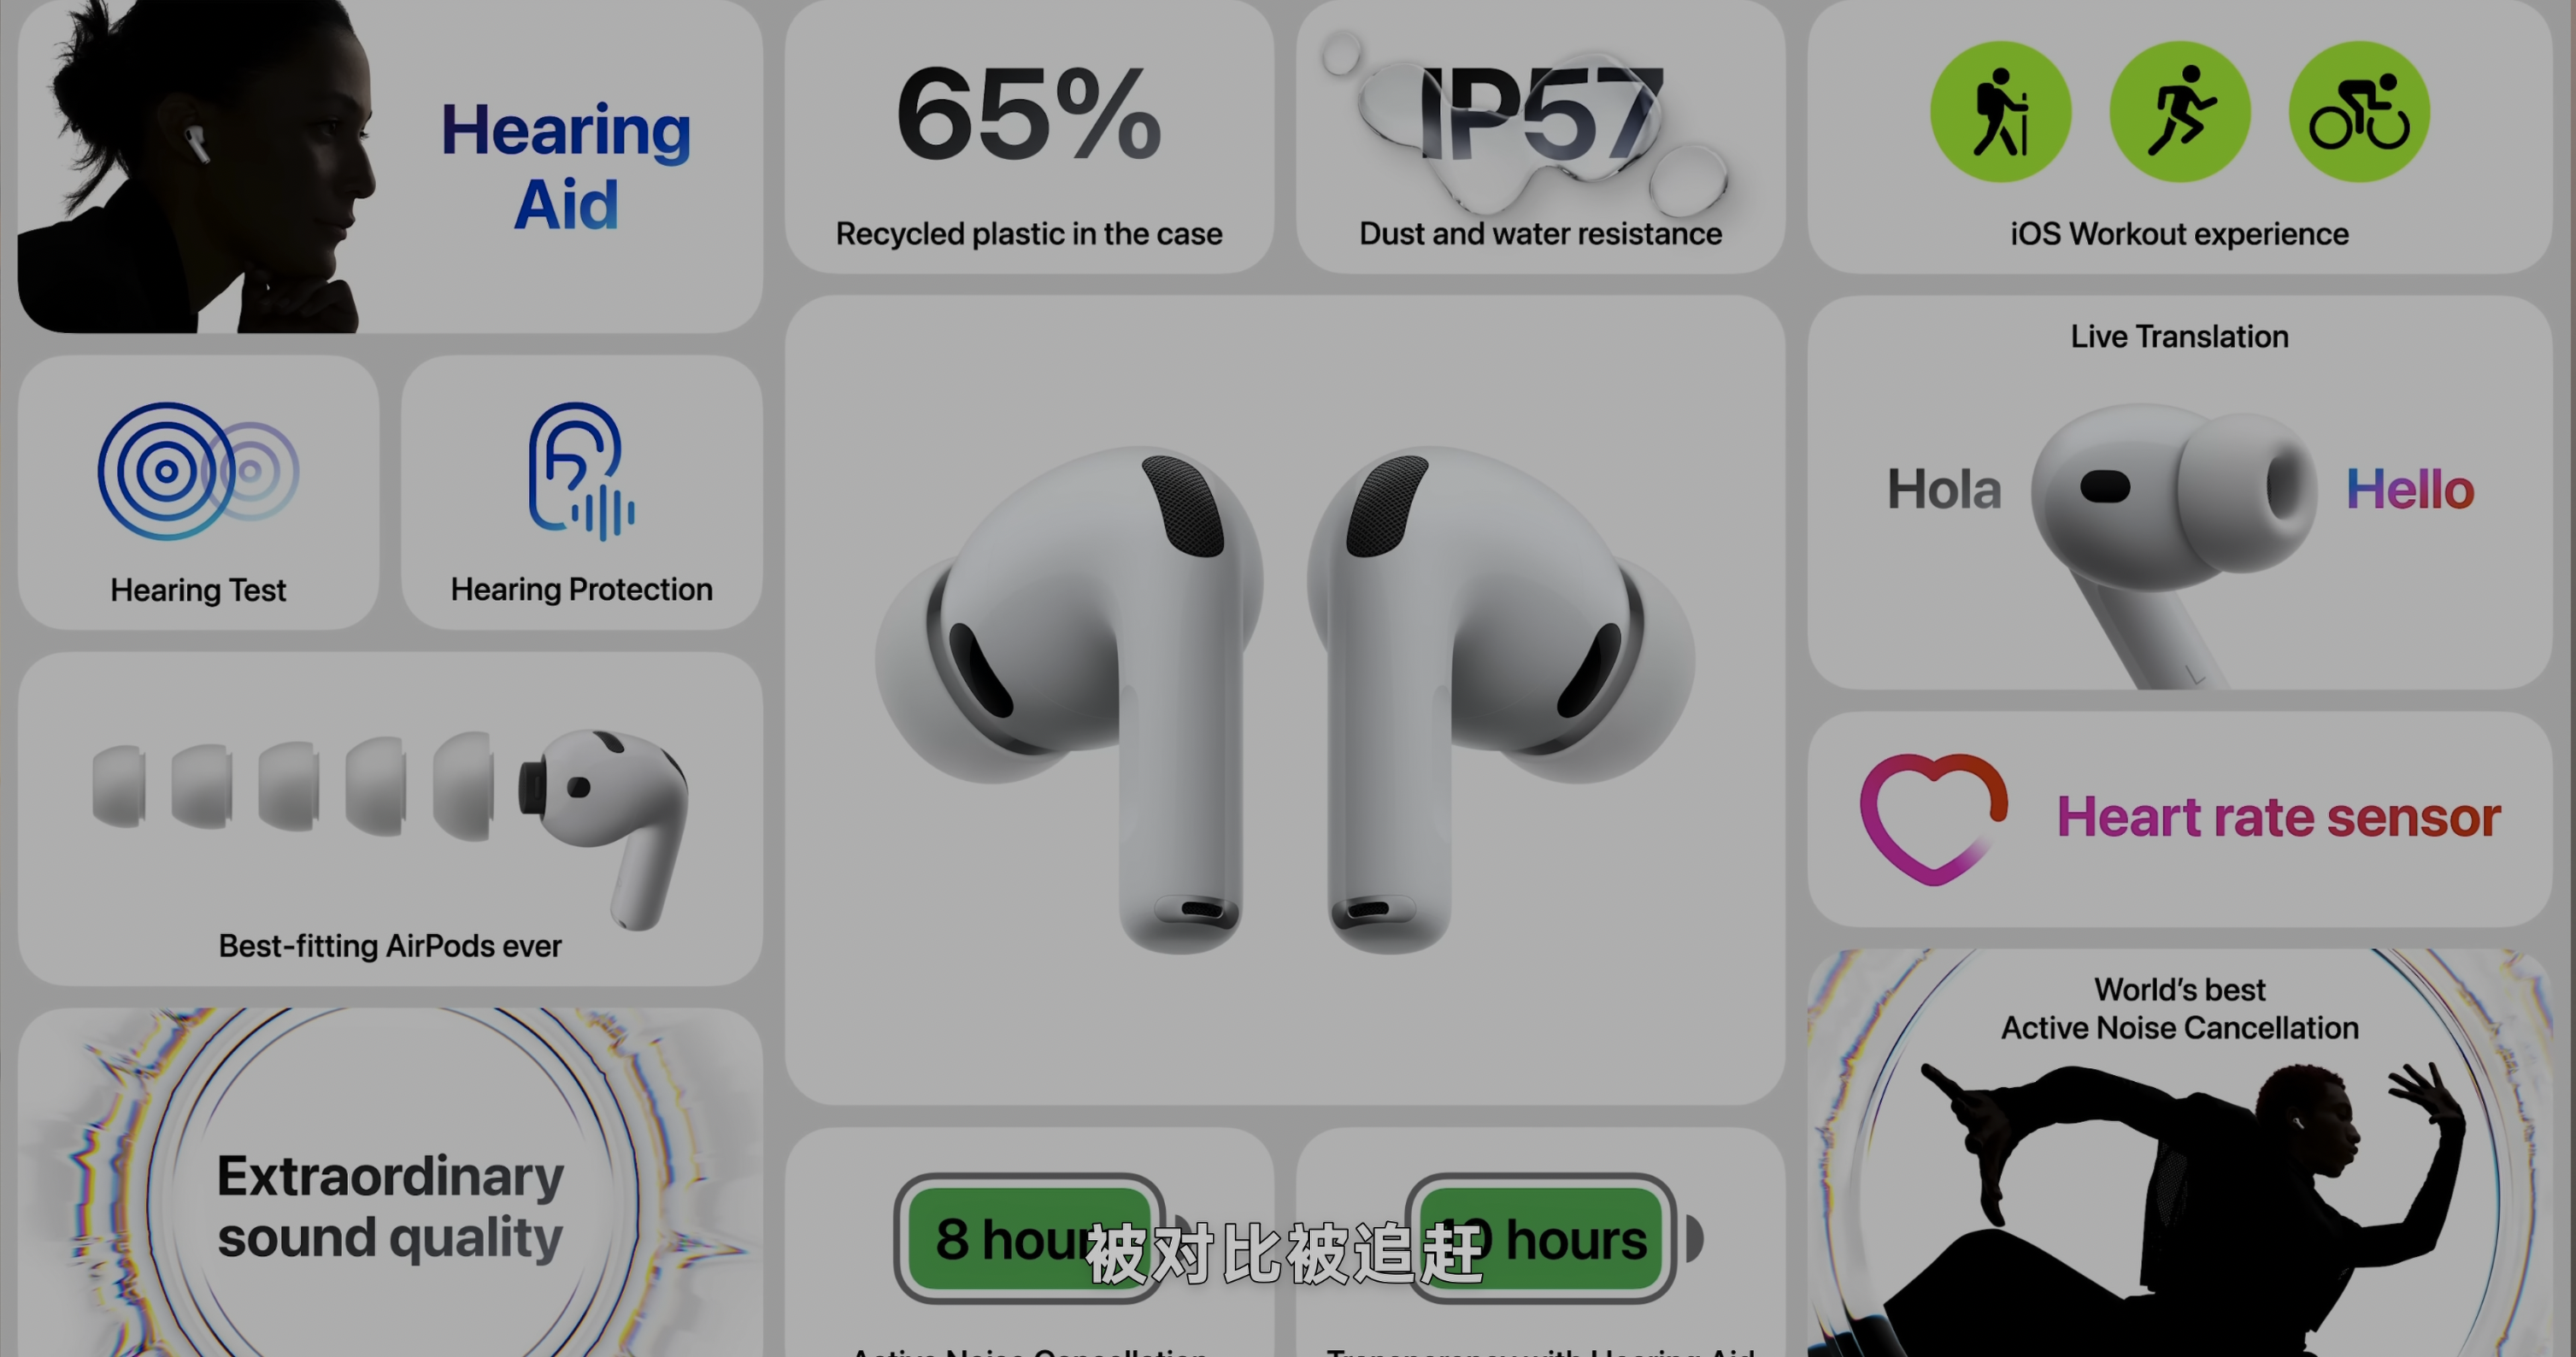
它不是一条专利,不是一颗芯片,也不是某次收购。那些东西都可以被列出来,被对比,被追赶。更难复制的是一种组织能力:让一个足够专的团队,长期负责一类体验;又让这个团队的能力,穿过不同产品线,在新的设备出现时重新组合。耳机只是冰山一角。
水面之下,是苹果专利中留下的一串名字,和一套仍在持续生长的系统。